Google y OpenAI atacan la latencia del agente de voz por caminos opuestos
Gemini 3.8 Live Extended Thinking razona dentro de la propia sesión de voz; GPT-Live-1 delega el razonamiento en un modelo de fondo y deja la coordinación en manos de la aplicación.

Google ha publicado Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking en la API de Gemini y en AI Studio, cinco días después de que OpenAI sacara GPT-Live-1. Los dos resuelven el mismo problema —que el agente no se quede mudo mientras consulta una herramienta— y lo hacen de maneras que no se parecen en nada. La elección entre uno y otro es, sobre todo, una decisión de arquitectura.
Razonar dentro de la sesión
Extended Thinking mantiene habla, razonamiento y ejecución de herramientas en una única sesión con estado, incluso mientras siguen corriendo llamadas a APIs externas. Si una función está marcada como NON_BLOCKING, el modelo sigue hablando mientras espera la respuesta: pregunta, comenta, da parciales. Cuando el resultado llega, retoma desde ahí. El esfuerzo de razonamiento se ajusta por petición en tres niveles (low, medium, high). La versión estándar de Gemini 3.8 Live se salta ese paso extendido para recortar latencia y gasto en tokens.
El mismo modelo base alimenta Gemini Live en la aplicación de consumo, que Google sitúa como su oferta de usuario final, más comparable a ChatGPT o Claude Voice que los modelos para desarrolladores. La multimodalidad se mantiene en los nuevos modelos de audio.
Dos capas que coordina tu aplicación
GPT-Live-1 hace lo contrario. El modelo de voz se encarga de la conversación full-duplex y un modelo de fondo —GPT-6 Astra, uno más ligero como Luna o incluso uno de terceros— asume el razonamiento y las llamadas a herramientas por separado. Mantener ese trabajo fuera de la voz permite que la capa conversacional siga respondiendo: OpenAI sitúa el turn-taking en torno a 800 milisegundos. El precio es que el desarrollador tiene que pasar contexto entre las dos capas por canales sideband y decidir qué dice el agente mientras el trabajo de fondo avanza. Toda esa orquestación vive en la aplicación.
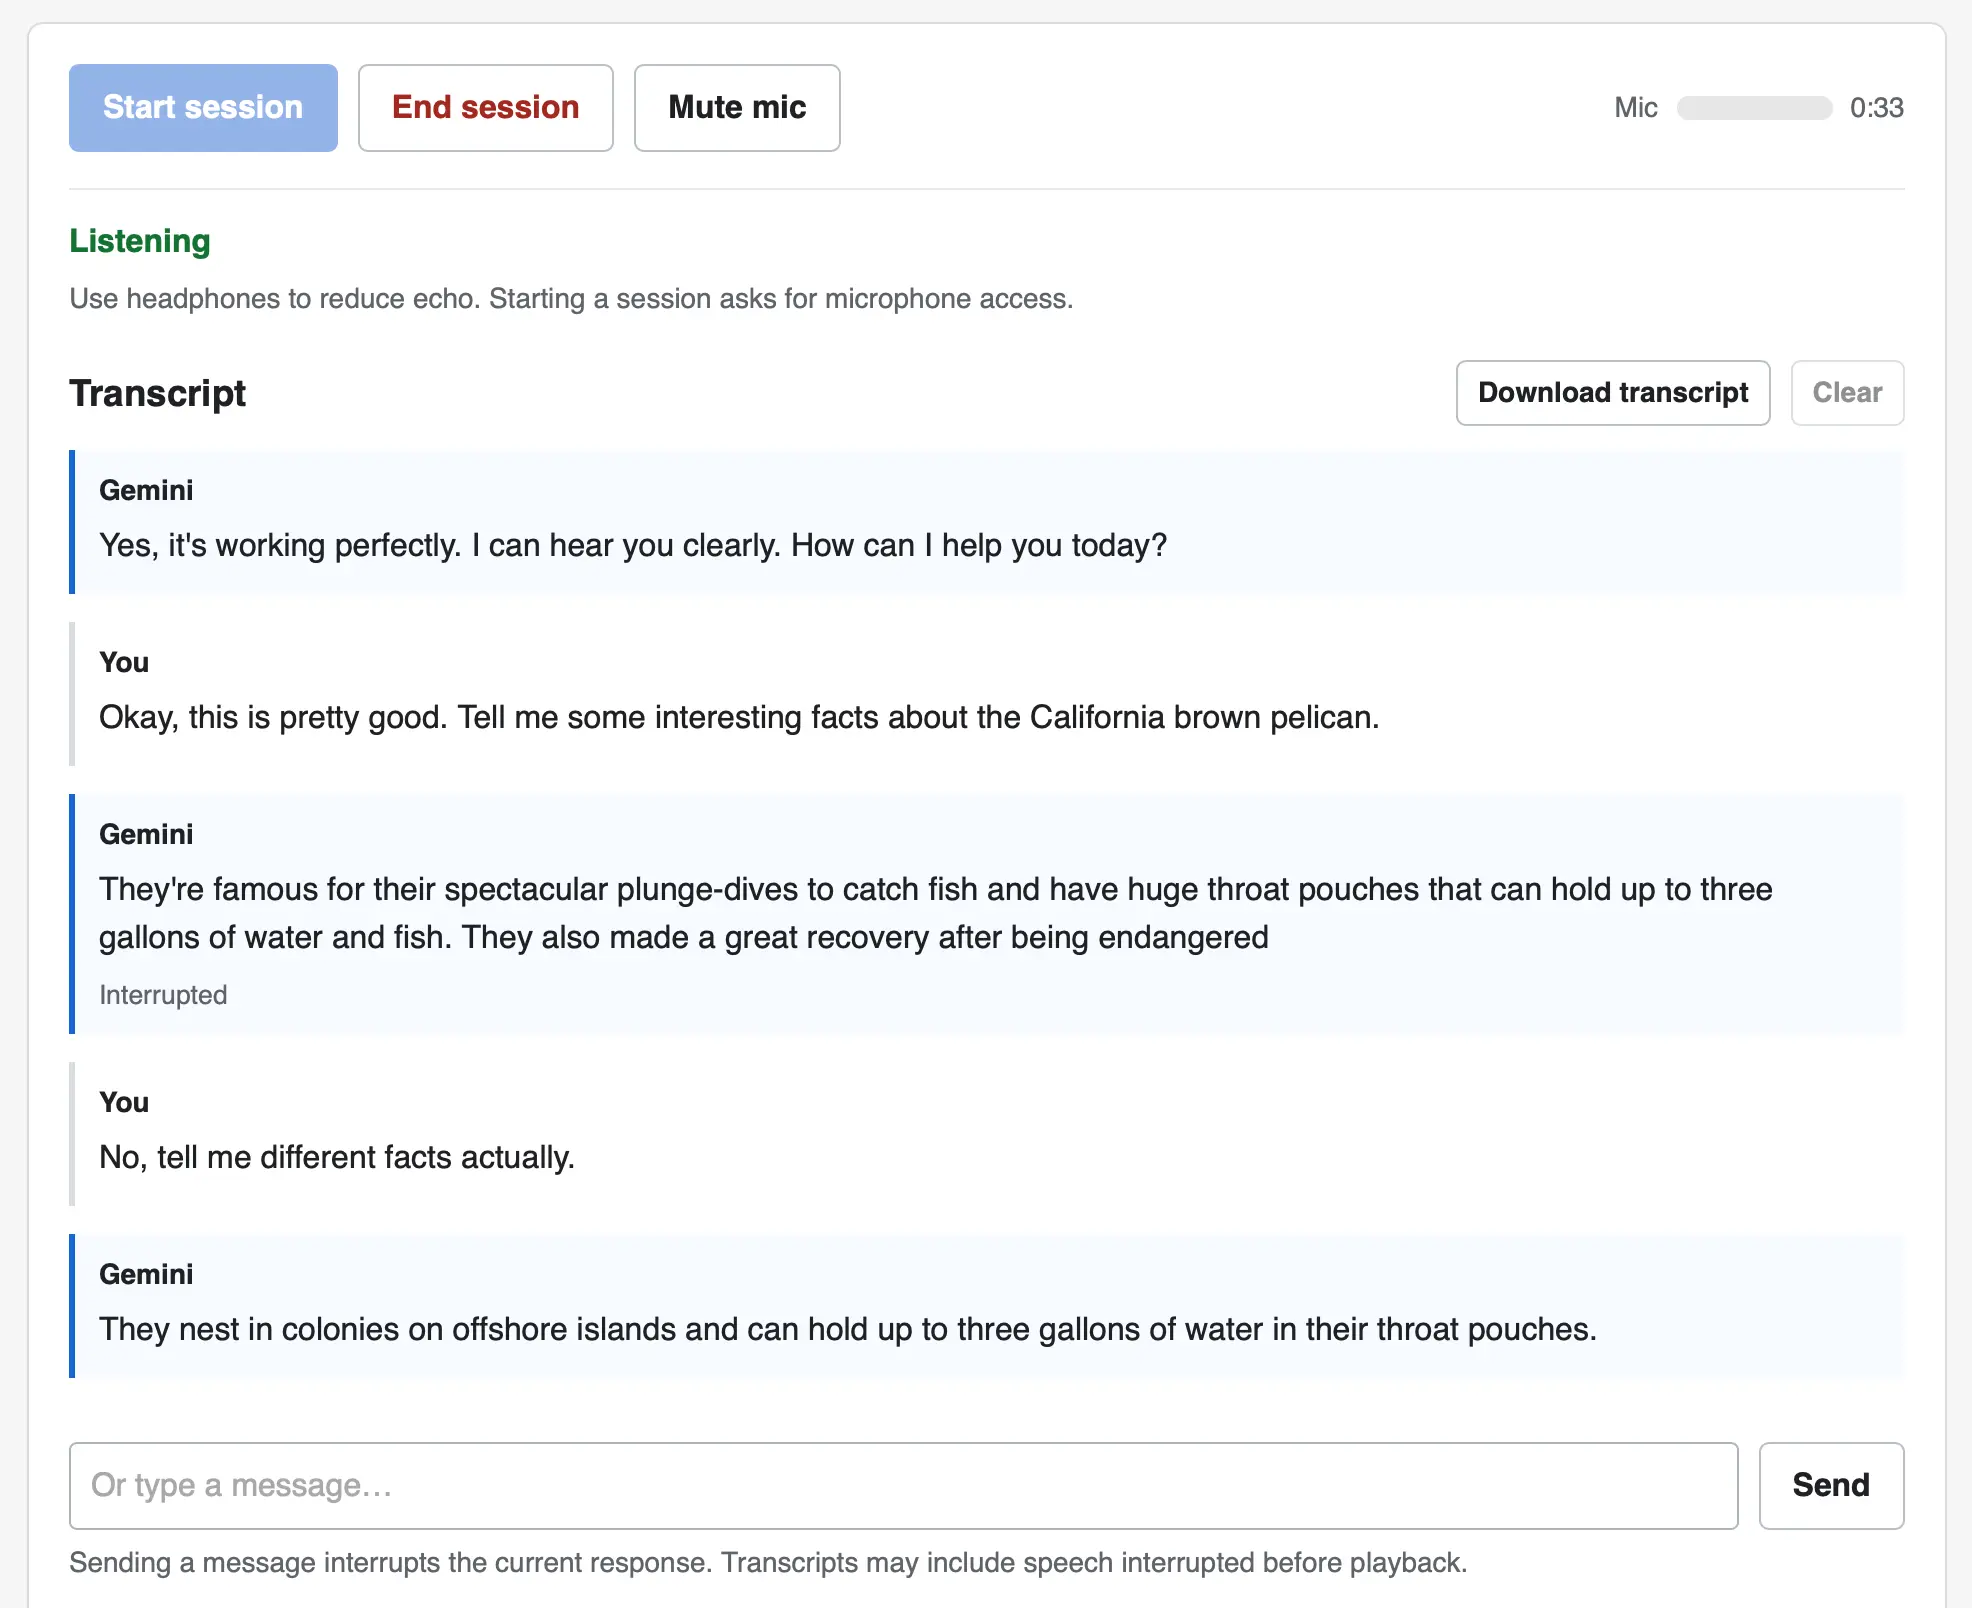
Con las interrupciones aparecen los problemas compartidos. Si el usuario cambia de idea a mitad de petición, queda trabajo en marcha que ya no sirve. En Gemini sigue dentro de la misma sesión, con menos visibilidad sobre cuándo se detiene una llamada. OpenAI deja más limpieza al desarrollador: hay que cancelar los trabajos pendientes y asegurarse de que una respuesta obsoleta no se cuela en la conversación. Google sostiene que Extended Thinking aguanta mejor el ruido de fondo, los acentos cerrados y las interrupciones inesperadas.
El coste separa más que los benchmarks. Gemini 3.8 Live va a las tarifas de la API de Gemini Live: 0,005 dólares por minuto de audio de entrada y 0,018 por minuto de salida. Extended Thinking añade tokens de razonamiento y cobra aparte entradas como vídeo en directo o documentos. GPT-Live-1 cuesta 0,05 dólares por minuto de voz solo en la capa frontal; el modelo de razonamiento, las llamadas a funciones y los agentes externos se facturan por su cuenta. Un agente que tire de un razonador potente en cada turno lo va a notar. OpenAI además incrusta en el audio generado la marca de agua SynthID de DeepMind.
Números que no se pueden comparar
Extended Thinking anotó 82,6 puntos en el índice de calidad voz a voz de Artificial Analysis, con tasas de finalización de tarea del 68,6% en τ-Voice y del 35,1% en el τ-Voice-banking de Sierra. GPT-Live-1, emparejado con GPT-6 Astra en esfuerzo medio, logró un 86,2% de Pass@1 en la evaluación de atención al cliente hablada de Tau3 (aerolíneas, retail y telecomunicaciones), y en Full Duplex Bench superó a GPT-Realtime-2.1 en 30 puntos porcentuales. Son pruebas distintas, montajes distintos y ninguna compara los dos modelos cara a cara. Google lo admite y añade que parte de las comparaciones públicas enfrentan modelos para desarrolladores con productos de consumo terminados.
Anthropic queda fuera de esta discusión: ofrece voz en sus aplicaciones de consumo, pero no tiene una API de voz a voz en tiempo real equivalente a Gemini Live o GPT-Live-1. Quien construya agentes de voz sobre Claude sigue montando buena parte del stack por su cuenta. Lo que se decide esta semana no es qué modelo habla mejor, sino cuánta orquestación quiere asumir tu aplicación y cuánto estás dispuesto a pagar por minuto de conversación.