Google publica Gemini 3.8 Live, dos modelos de voz a voz con API WebSocket
Los dos modelos siguen el patrón de la familia GPT-Live de OpenAI y ya se pueden probar desde el navegador contra el endpoint WebSocket de la API de Gemini.
Google ha publicado Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking, dos modelos de voz a voz con la misma forma que la familia GPT-Live de OpenAI: entra audio, sale audio, sin pasar por texto intermedio. Los dos están disponibles desde hoy.
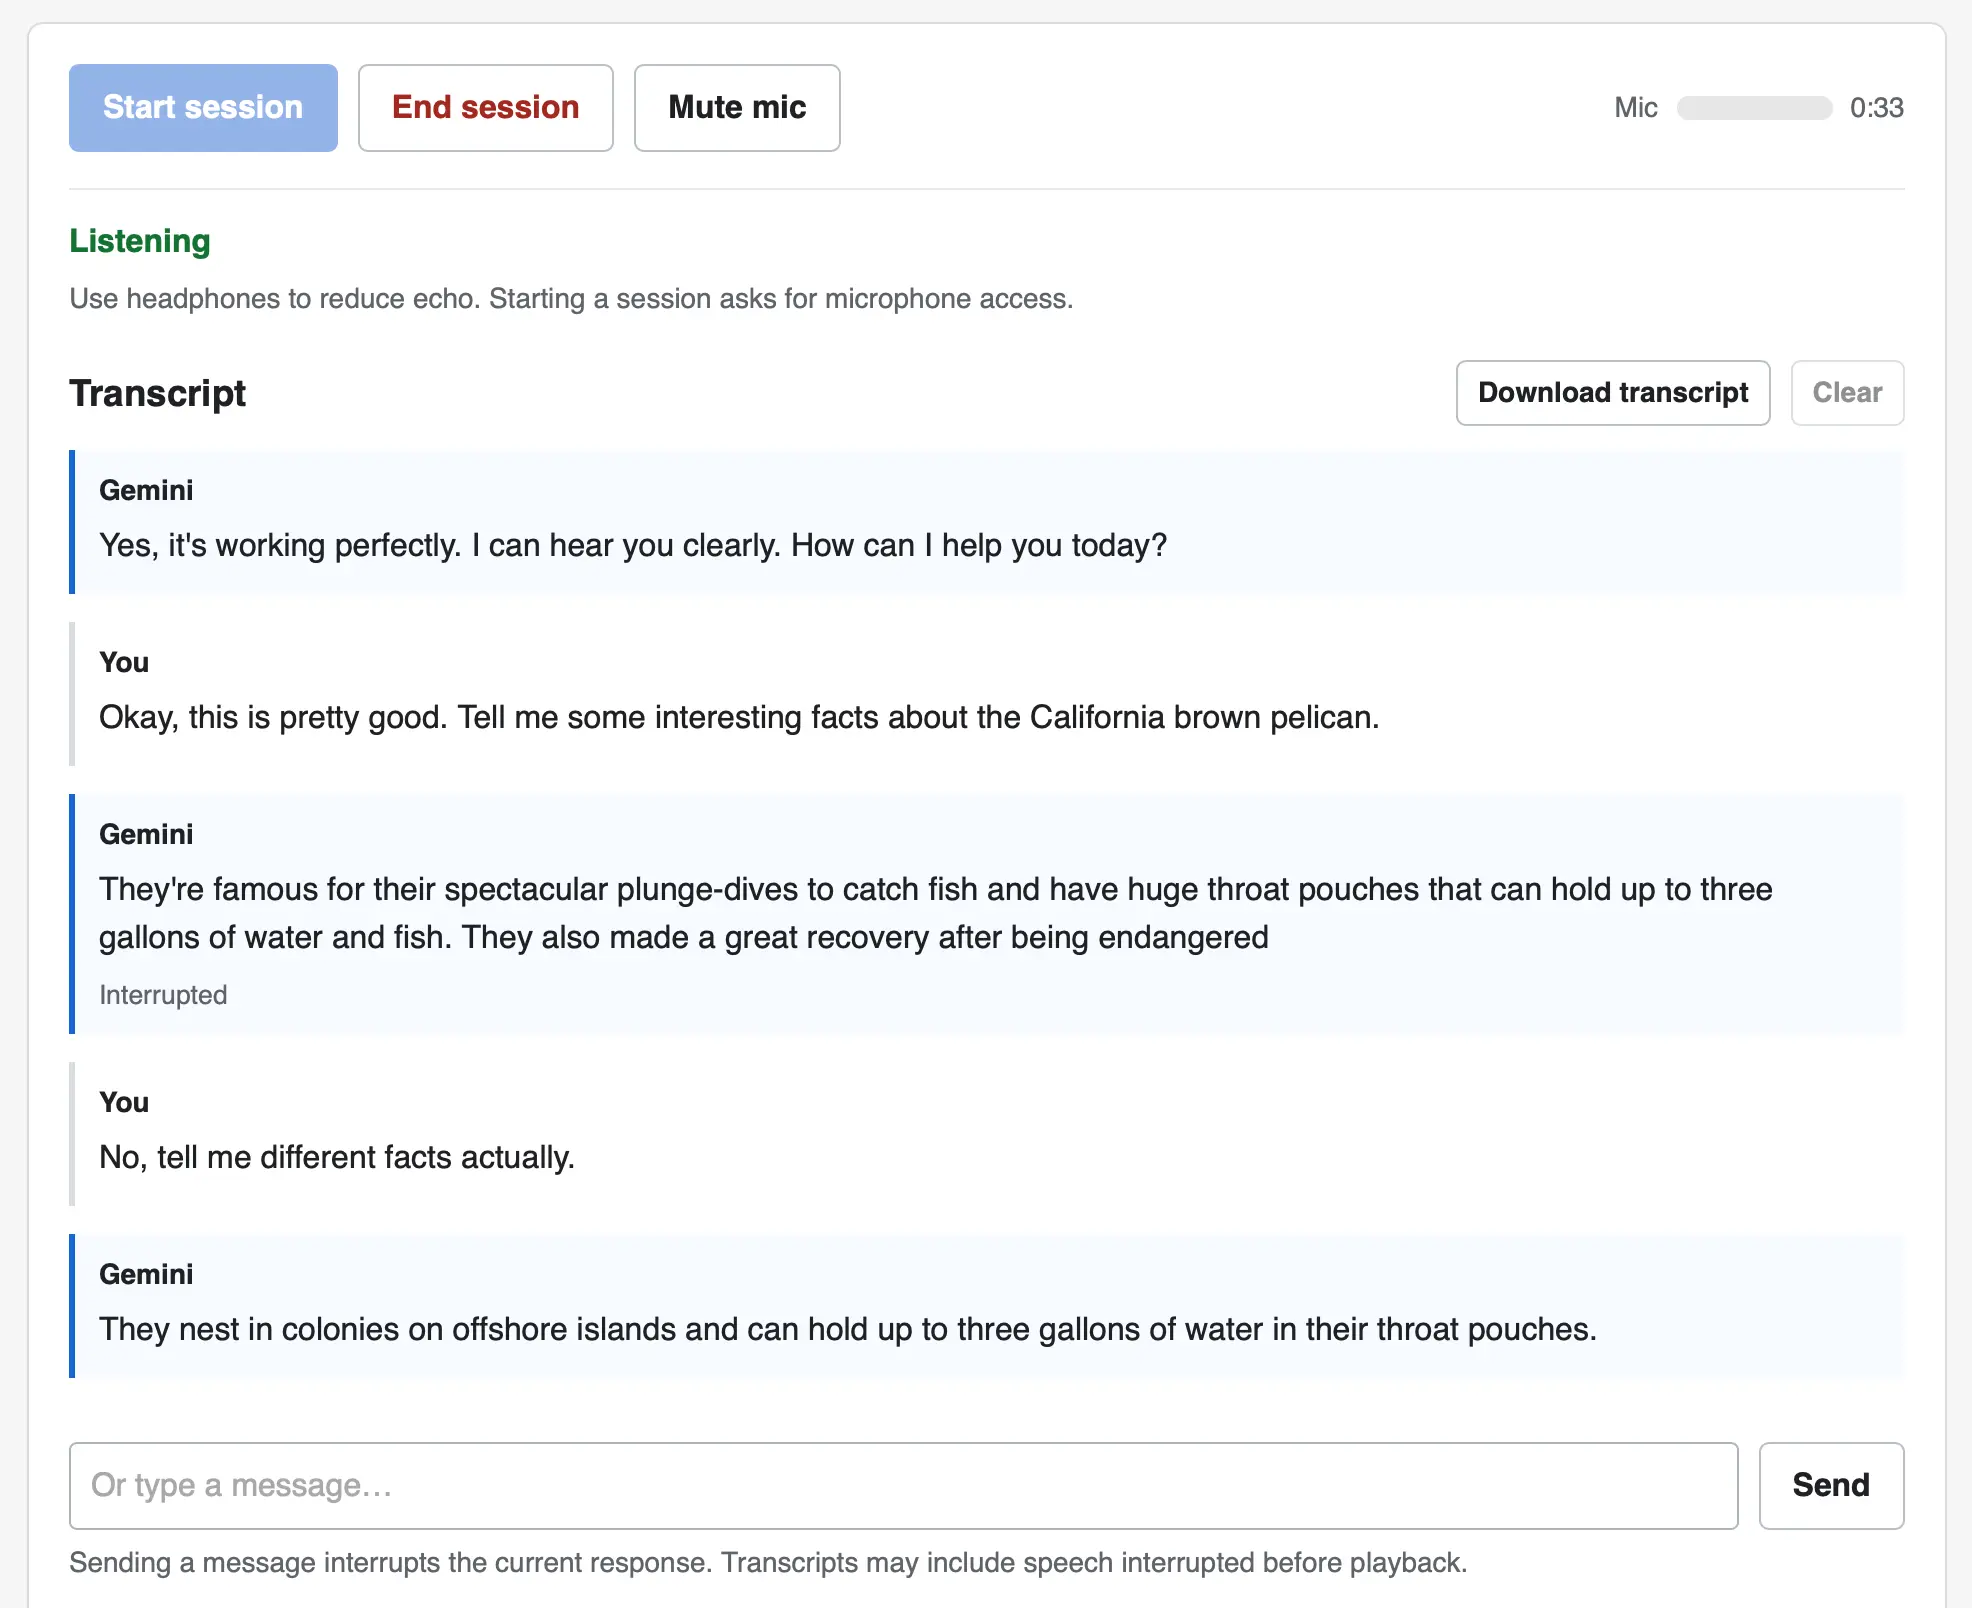
La parte que le importa a quien vaya a integrarlos es el transporte. Simon Willison ha publicado una interfaz web para probarlos, montada a partir de la documentación del modelo: se elige modelo y preset de voz, se escribe opcionalmente un system prompt y se arranca una conversación hablada en el navegador, incluida la posibilidad de interrumpir al modelo mientras está hablando. La implementación no usa ninguna librería.
Qué hay debajo
La demo se conecta al endpoint WebSocket wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=... y resuelve tanto la captura de micrófono como la reproducción con un AudioContext de la Web Audio API. Es decir: WebSocket crudo y APIs del navegador, sin capa intermedia que abstraiga el streaming bidireccional.
Para quien quiera montar algo parecido, Google mantiene una guía de primeros pasos con la API WebSocket. Dos cosas a mirar antes de llevar esto a producción: el endpoint apunta a la versión v1alpha de la API, y la clave de autenticación viaja en la propia URL como parámetro de consulta, algo que conviene tener presente si los logs del proxy guardan las peticiones enteras.
El patrón de voz a voz se está cerrando rápido. OpenAI lo tiene con GPT-Live, Google responde con esta familia y ambos coinciden en la forma: sesión persistente, audio en streaming y capacidad de cortar al modelo a media frase. Para un backend que hasta ahora encadenaba transcripción, LLM y síntesis en tres llamadas, esto reduce la latencia y quita piezas móviles, a cambio de atarse a un protocolo propietario sobre WebSocket y a una API en alpha.
Lo que queda por ver es si la variante Extended Thinking añade latencia suficiente como para notarse en una conversación, y si Google mantiene el endpoint estable cuando la API salga de v1alpha. De momento, el ejemplo entero cabe en un HTML y se puede copiar.