Jev genera seis clones en dos días y reabre el debate de los modelos discriminativos
El modelo de decisión Jev acumula 36 millones de visualizaciones y seis reproducciones no oficiales en dos días, varias construidas sobre Qwen y ModernBERT con datos sintéticos.
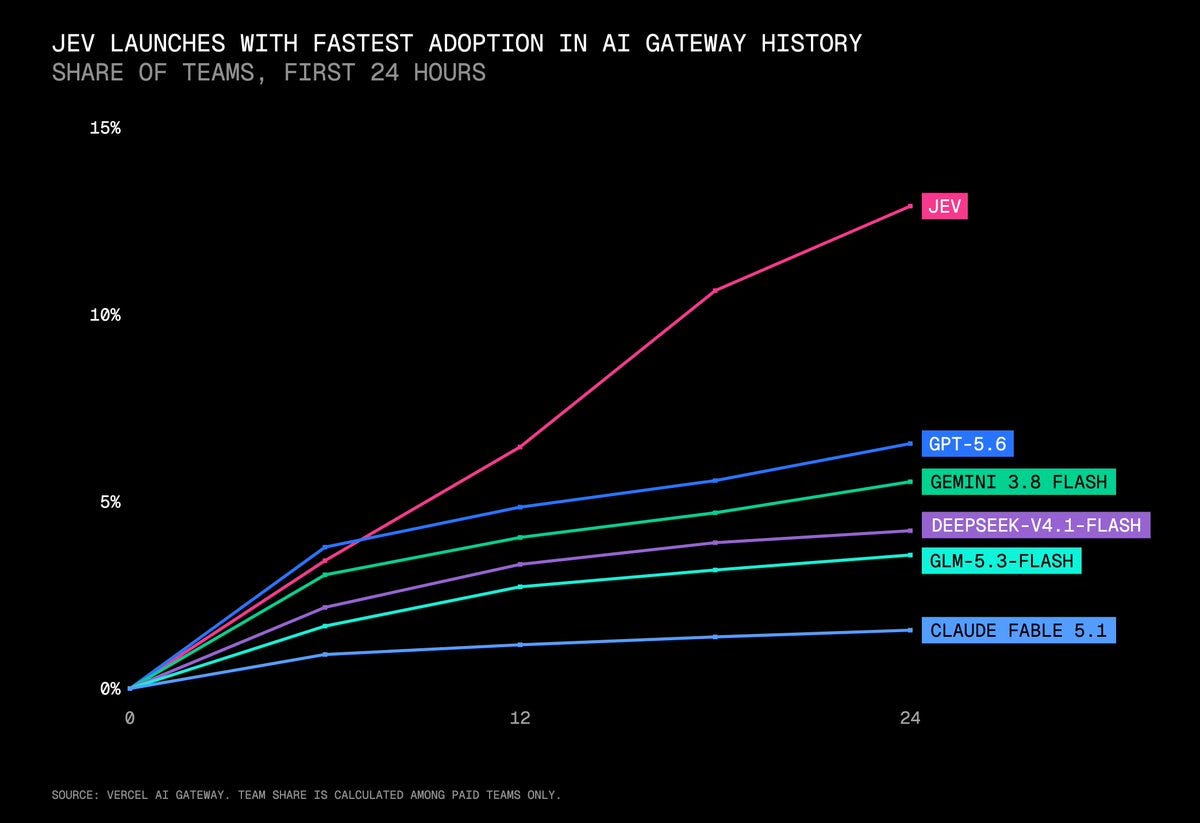
Jev se presentó el miércoles y en dos días su vídeo de lanzamiento acumula 36 millones de visualizaciones. Vercel afirma que fue el modelo con adopción más rápida en la historia de su AI Gateway, y la medición de typesafeai le da un 13% de los equipos en el primer día: el doble que la familia GPT-5.6 y seis veces más que Fable 5.1. No es open source, así que la comunidad se puso a especular con su arquitectura. En 48 horas ya había seis reproducciones no oficiales.
Lo que se discute aquí no es un chatbot. Jev es un modelo discriminativo de decisión, planteado como un "System 1" rápido que complementa a un LLM generativo: en vez de escribir, puntúa opciones con probabilidades calibradas. Sirve para enrutar peticiones, elegir una cita, decidir un escalado o resolver una llamada a herramienta sin gastar un modelo grande. En Braintrust aparece como modelo de evaluación con un coste de puntuación unas 400 veces menor que los montajes anteriores, una cifra que difundieron los propios implicados.
Seis reconstrucciones en dos días
- Laya: 421 millones de parámetros, encoder ModernBERT-large con dos capas transformer añadidas que puntúan las opciones del usuario. Entrenado con PPO sobre embeddings de secuencia para producir trayectorias de conversión, con probabilidades entre 0 y 1.
- DiffusionGemmaJev: lo ataca desde un modelo de difusión y queda cerca en los benchmarks.
- Bespoke Nimble: ajuste LoRA de Qwen3.5-9B con curación de datos contrastivos. Sube el Qwen base del 66% al 90% en su eval propia, frente al 93% de Jev, con 100 ms en H100.
- OpenJev, ahora SemIf: backbone Qwen3.5 causal de 4B y 35B con un clasificador NLI de tres clases sobre el último token.
- Jevlike: embeddings de byte de 40K y un modelo ligero de atención sobre opciones; cada candidata es una query que lee de una representación compartida.
- Kev-0.5B: adaptador LoRA y una cabeza de lectura sobre Qwen2.5-0.5B. Corre en un MacBook Pro.
Nadie discute demasiado la parte de datos, que se reconoce 100% sintética. Ahí está una de las críticas que han aparecido: las demos insisten en la velocidad y no tanto en la calidad, y la categoría sigue sin un benchmark estándar. Otra es que el entusiasmo divide por experiencia previa: quien llegó después de ChatGPT lo vive como una revelación y quien venía del ML anterior a GPT no entiende el ruido.
Los primeros usos con sustancia están en flujos de navegador y computer use. Hay demos que clasifican informes de incidencias en rutas de escalado, otras que combinan LangChain con Jev para tareas de navegación estructurada, y un plugin que le da un navegador dentro de Cline. Quien lo ha probado en ese terreno dice que es donde mejor encaja.
La cosa va menos de chatbots y más de plano de control de flujos. Si el patrón cuaja, las decisiones baratas —enrutado, escalado, selección— salen de los modelos generativos pequeños y bajan a modelos discriminativos que pueden correr en local. En paralelo, la otra noticia de la semana es de convenciones: Claude Code empieza a leer AGENTS.md cuando no encuentra CLAUDE.md, lo que consagra el formato como estándar entre herramientas y elimina ficheros puente. Los análisis sobre diseño de harness apuntan en la misma dirección: con cuatro herramientas básicas —leer, escribir, editar, bash— se llega a la frontera de Pareto en rendimiento y se recorta gasto. La elección de modelo también se está partiendo en dos: uno caro para planificar y otro barato para ejecutar.