Un modelo de 4B produce planes de consulta más rápidos que el optimizador de Postgres
El experimento entrena un modelo abierto de 4.000 millones de parámetros con ajuste supervisado y refuerzo, y recorta la latencia un 44,7% en 113 consultas con muchos joins.
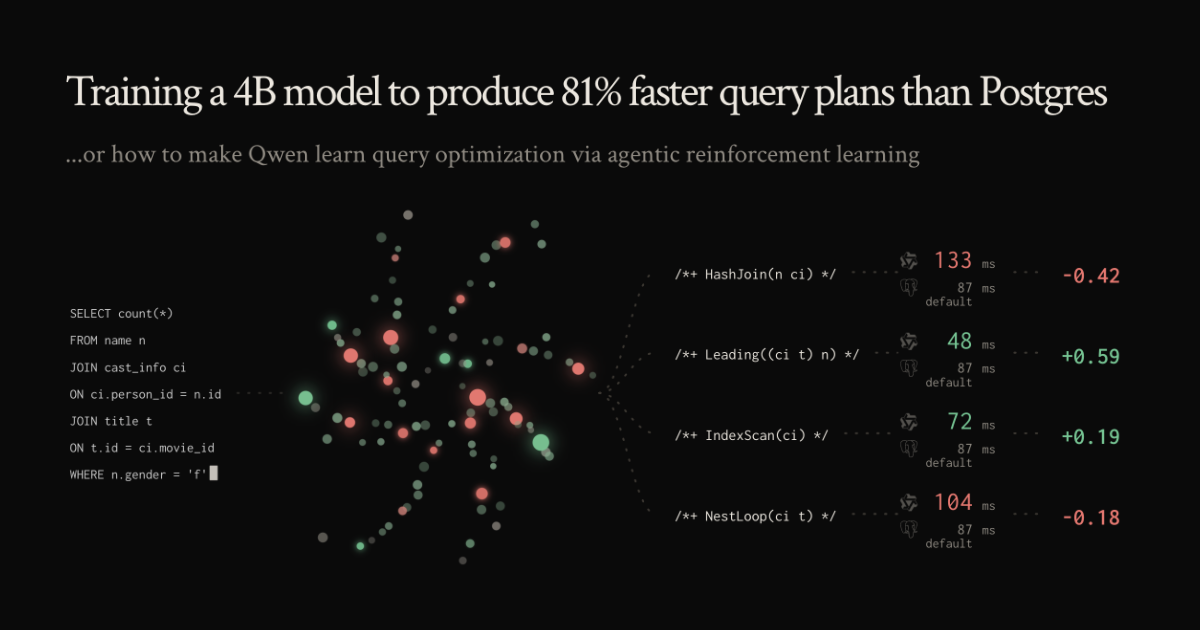
Un desarrollador ha entrenado un modelo abierto de 4.000 millones de parámetros para que genere planes de consulta de Postgres mejores que los que elige el optimizador por defecto. El modelo partía sin saber producir un plan para 99 de las 113 consultas con muchos joins de su banco de pruebas, y tras ajuste supervisado y aprendizaje por refuerzo logró recortar la latencia media un 44,7% en ese conjunto.
La cifra del titular que usa el autor es otra: planes un 81% más rápidos. La del 44,7% es la agregada que aparece en el detalle. Las dos son suyas, medidas en su propio montaje, no de un tercero.
Elegir el orden de los joins es NP-hard
La pregunta de si los optimizadores de consultas son buenos tiene ya una década larga de literatura: Leis et al. la formularon en 2015 y volvieron a ella diez años después, y la conclusión seguía siendo que dejan bastante que desear. En un join de tres tablas, como el ejemplo del conjunto IMDb (title, movie_companies, company_name), los predicados selectivos sobre el código de país y el año de producción cambian por completo qué orden conviene. Con las tablas sin filtrar da casi igual empezar por un lado que por otro; con el filtro de compañías japonesas y el rango de años, las cardinalidades intermedias se desploman y el orden pasa a importar de verdad. El optimizador estima esos tamaños asumiendo distribuciones uniformes, y ahí es donde se equivoca.
Lo interesante para el experimento es que verificar si un plan es bueno no es difícil: se ejecuta y se cronometra. Una sola métrica, automática. Eso es justo el tipo de tarea para la que sirve el aprendizaje por refuerzo.
Del banco de pruebas al entrenamiento
El autor montó un medidor propio sobre cuatro contenedores de Postgres corriendo en su escritorio y diseñó una variante de GRPO para puntuar trayectorias en un entorno con ruido, con cuidado de no contaminar la medición con la contención de la caché de páginas de Linux entre contenedores concurrentes. El entrenamiento lo repartió en dos máquinas: vLLM y el entrenador en un nodo de 2x H100 alquilado, y las bases de datos en local. También hizo destilación a partir de medio millar de trayectorias de un agente GPT-6 Astra. El código está en qorl.
Queda por ver si esto aguanta fuera del IMDb y de esas 113 consultas. Un modelo que elige planes no es un optimizador integrado: hoy la vía habitual para forzar un plan sigue siendo una extensión como pg_hint_plan, y la pista hay que escribirla a mano. Que un modelo de 4.000 millones de parámetros aprenda a acertar más que el planificador por defecto dice menos sobre reemplazarlo que sobre lo explotable que es la señal de recompensa cuando el resultado se puede cronometrar.