scikit-LLM mete los LLM en la API de scikit-learn y estrena hoja de referencia
La librería expone modelos de lenguaje como estimadores con fit y predict, así que entran en un Pipeline o en una validación cruzada. El coste en tokens es lo que hay que vigilar.
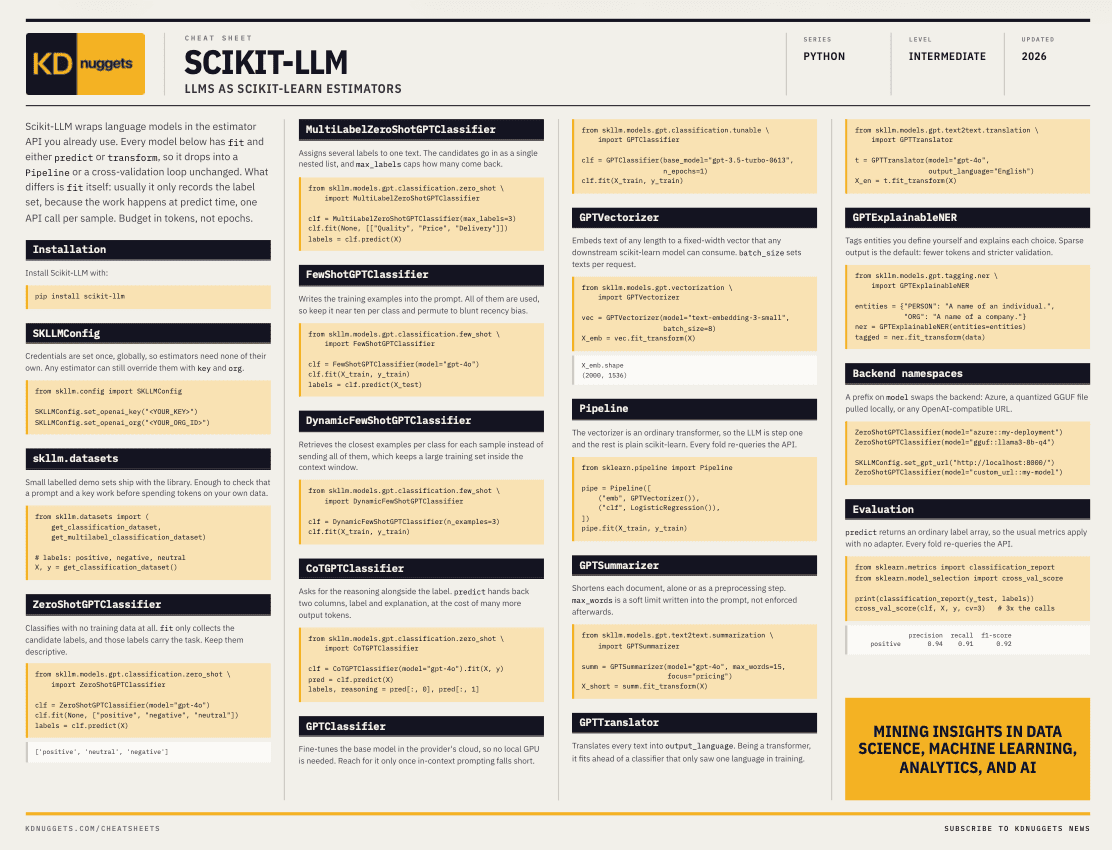
scikit-LLM mete modelos de lenguaje dentro de la API de estimadores de scikit-learn. Cada clase expone fit y predict o transform, de modo que se puede colocar en un Pipeline o dentro de un bucle de validación cruzada como cualquier otro estimador. La librería vive en scikit-LLM y acaba de aparecer una hoja de referencia que resume sus clases principales.
El detalle que descoloca al principio es fit. En la mayoría de estos estimadores no entrena nada: registra el conjunto de etiquetas y deja el trabajo real para predict, que hace una llamada a la API por muestra. Pensar en tokens, y no en epochs, es la forma correcta de planificar una ejecución.
Los estimadores que importan
ZeroShotGPTClassifier es el que más se acaba usando. Se invoca con fit(None, [...]) y solo etiquetas candidatas, algo que choca las primeras veces. La clave es que esas etiquetas son la especificación de la tarea: si son vagas, la salida es vaga. Conviene escribirlas como descripciones.
Cuando el zero-shot no llega, DynamicFewShotGPTClassifier es mejor opción que un few-shot plano. Recupera los ejemplos más cercanos de cada clase para cada muestra, en lugar de arrastrar todo el conjunto de entrenamiento en cada prompt.
GPTVectorizer convierte texto de cualquier longitud en un vector de ancho fijo. Eso deja al modelo como primer paso del pipeline y todo lo que venga después vuelve a ser scikit-learn de toda la vida: una regresión logística sobre los embeddings, por ejemplo. GPTTranslator hace de transformador, así que se puede poner delante de un clasificador entrenado solo con textos en inglés sin reentrenarlo sobre un corpus multilingüe.
La factura
El aviso serio es el coste en tokens. Un cross_val_score con cv=3 son tres veces las llamadas a la API, y eso se multiplica en cuanto entra un grid search. Rutinas que en scikit-learn salían gratis aquí se pagan por petición.
Para quien ya trabaja con scikit-learn a diario, la librería es una forma de probar LLM sin salir de casa: el mismo Pipeline, los mismos informes, las mismas métricas. Lo que hay que decidir antes de llevarlo a producción es cuántas llamadas está dispuesto a pagar por evaluación, porque el diseño de la validación cruzada pasa a ser una decisión de presupuesto.