Un listado mide la antigüedad de 20 modelos de IA: lanzamiento y fecha de corte
El sitio stale.jock.pl reúne la fecha de lanzamiento y el corte de entrenamiento de 20 modelos de 8 laboratorios. Solo la mitad tiene una fecha de corte que su fabricante publique.
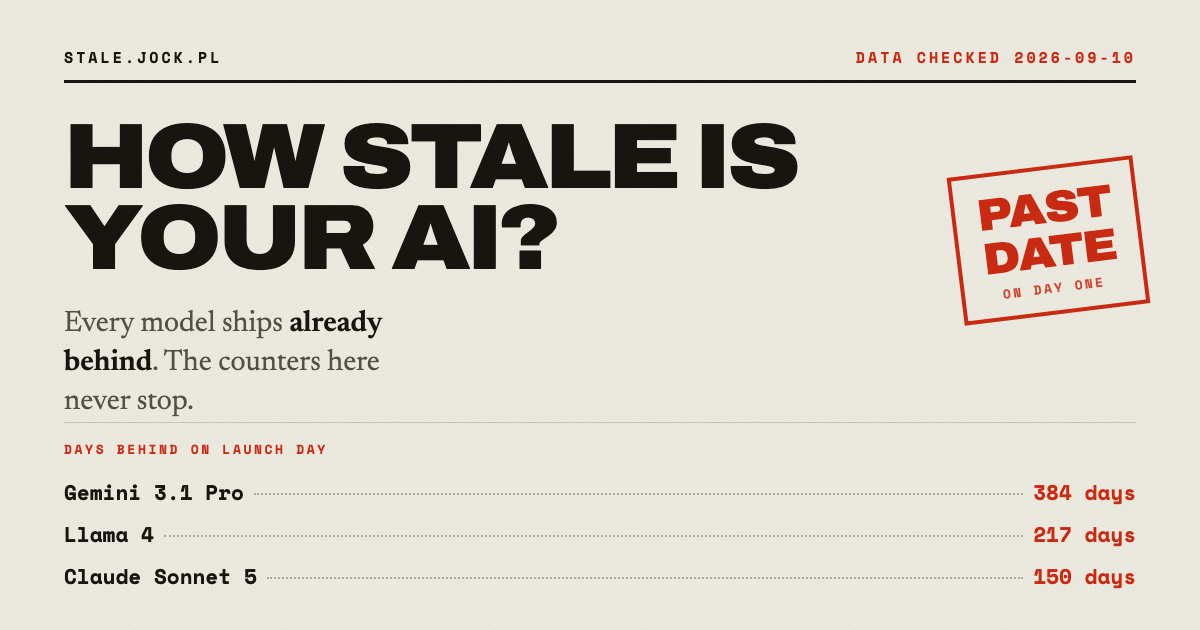
El sitio stale.jock.pl mantiene una tabla con las dos fechas que, según su autor, deciden si un modelo está al día: el día en que el laboratorio lo lanzó y el día en que dejó de leer. Cubre 20 modelos de 8 laboratorios, con contadores que suben en vivo desde cada fecha. Lo llamativo no es la lista, sino lo que falta en ella: solo 10 de los 20 tienen un corte de entrenamiento que su propio fabricante haga público.
La mitad de la tabla está en blanco
Cinco de los ocho laboratorios —Anthropic, Google DeepMind, Meta, OpenAI y xAI— publican el corte de al menos uno de sus modelos. Mistral AI, Alibaba y DeepSeek aparecen con la casilla vacía en todas sus fichas: Mistral Large 3, Mistral Small 4, Mistral Medium 3.5, Qwen3.8-Max, Qwen3.8-Flash, DeepSeek V4-Pro y DeepSeek V4.1-Flash. El autor aclara que un hueco significa que las fuentes consultadas no establecen el corte, no que el laboratorio no lo haya publicado nunca.
Los casos con dato son los que mejor enseñan la brecha. Llama 4 salió el 5 de abril de 2025 con material hasta agosto de 2024. GPT-6 Astra, lanzado el 3 de septiembre de 2026, dejó de leer el 30 de abril de 2026: cinco meses de retraso el mismo día en que se puso a disposición de cualquiera. Claude Opus 5 y Claude Fable 5.1 se quedan en mayo y junio de 2026 respectivamente. Cada nombre de la tabla enlaza al documento del laboratorio del que sale la fecha, y los contadores necesitan JavaScript para moverse; las fechas en crudo están en el HTML.
La página también responde a si la búsqueda web arregla el problema: no. Un modelo que consulta páginas no aprende nada, lee unas cuantas, las usa en esa respuesta y las olvida. Al abrir un chat nuevo vuelve a su corte. Las herramientas de búsqueda tapan el hueco, no lo cierran.
Para lo que sirve
El contenido está pensado para agentes. Se publica como models.json, con fecha de lanzamiento, corte publicado y enlace a la fuente de cada modelo, y con un fragmento listo para pegar en el AGENTS.md o el CLAUDE.md que el agente ya lee. La instrucción es directa: antes de dar por actual cualquier modelo, versión o fecha, que consulte ese JSON y trate como no verificado todo lo que lleve una fecha asociada. El archivo se regenera cada vez que se mueve la tabla, así que el agente lee las fechas de hoy y no las que quedaron cocidas en sus pesos. Hay además un llms.txt para rastreadores.
El valor de la pieza está en lo que obliga a mirar. Los números de versión y las fechas de lanzamiento son fáciles de seguir porque los laboratorios los anuncian a bombo y platillo; el corte de entrenamiento es el que casi nadie publica, y es el que determina si el modelo sabe algo del mundo o solo cree saberlo. Que un tercio de los laboratorios de la lista no lo declare en ningún modelo convierte cualquier respuesta con fecha en una apuesta. Lo que queda por ver es si el archivo se mantiene cuando la tabla se mueva, y si algún laboratorio empieza a publicar el corte por defecto en lugar de dejarlo en el aire.