SuperWhisper publica S1-mini, un modelo de 600M para limpiar transcripciones en local
Tiene 596 millones de parámetros, pesos abiertos y corre en la CPU de un portátil sin GPU ni conexión. Es el único modelo de la familia S1 que la compañía ha abierto.
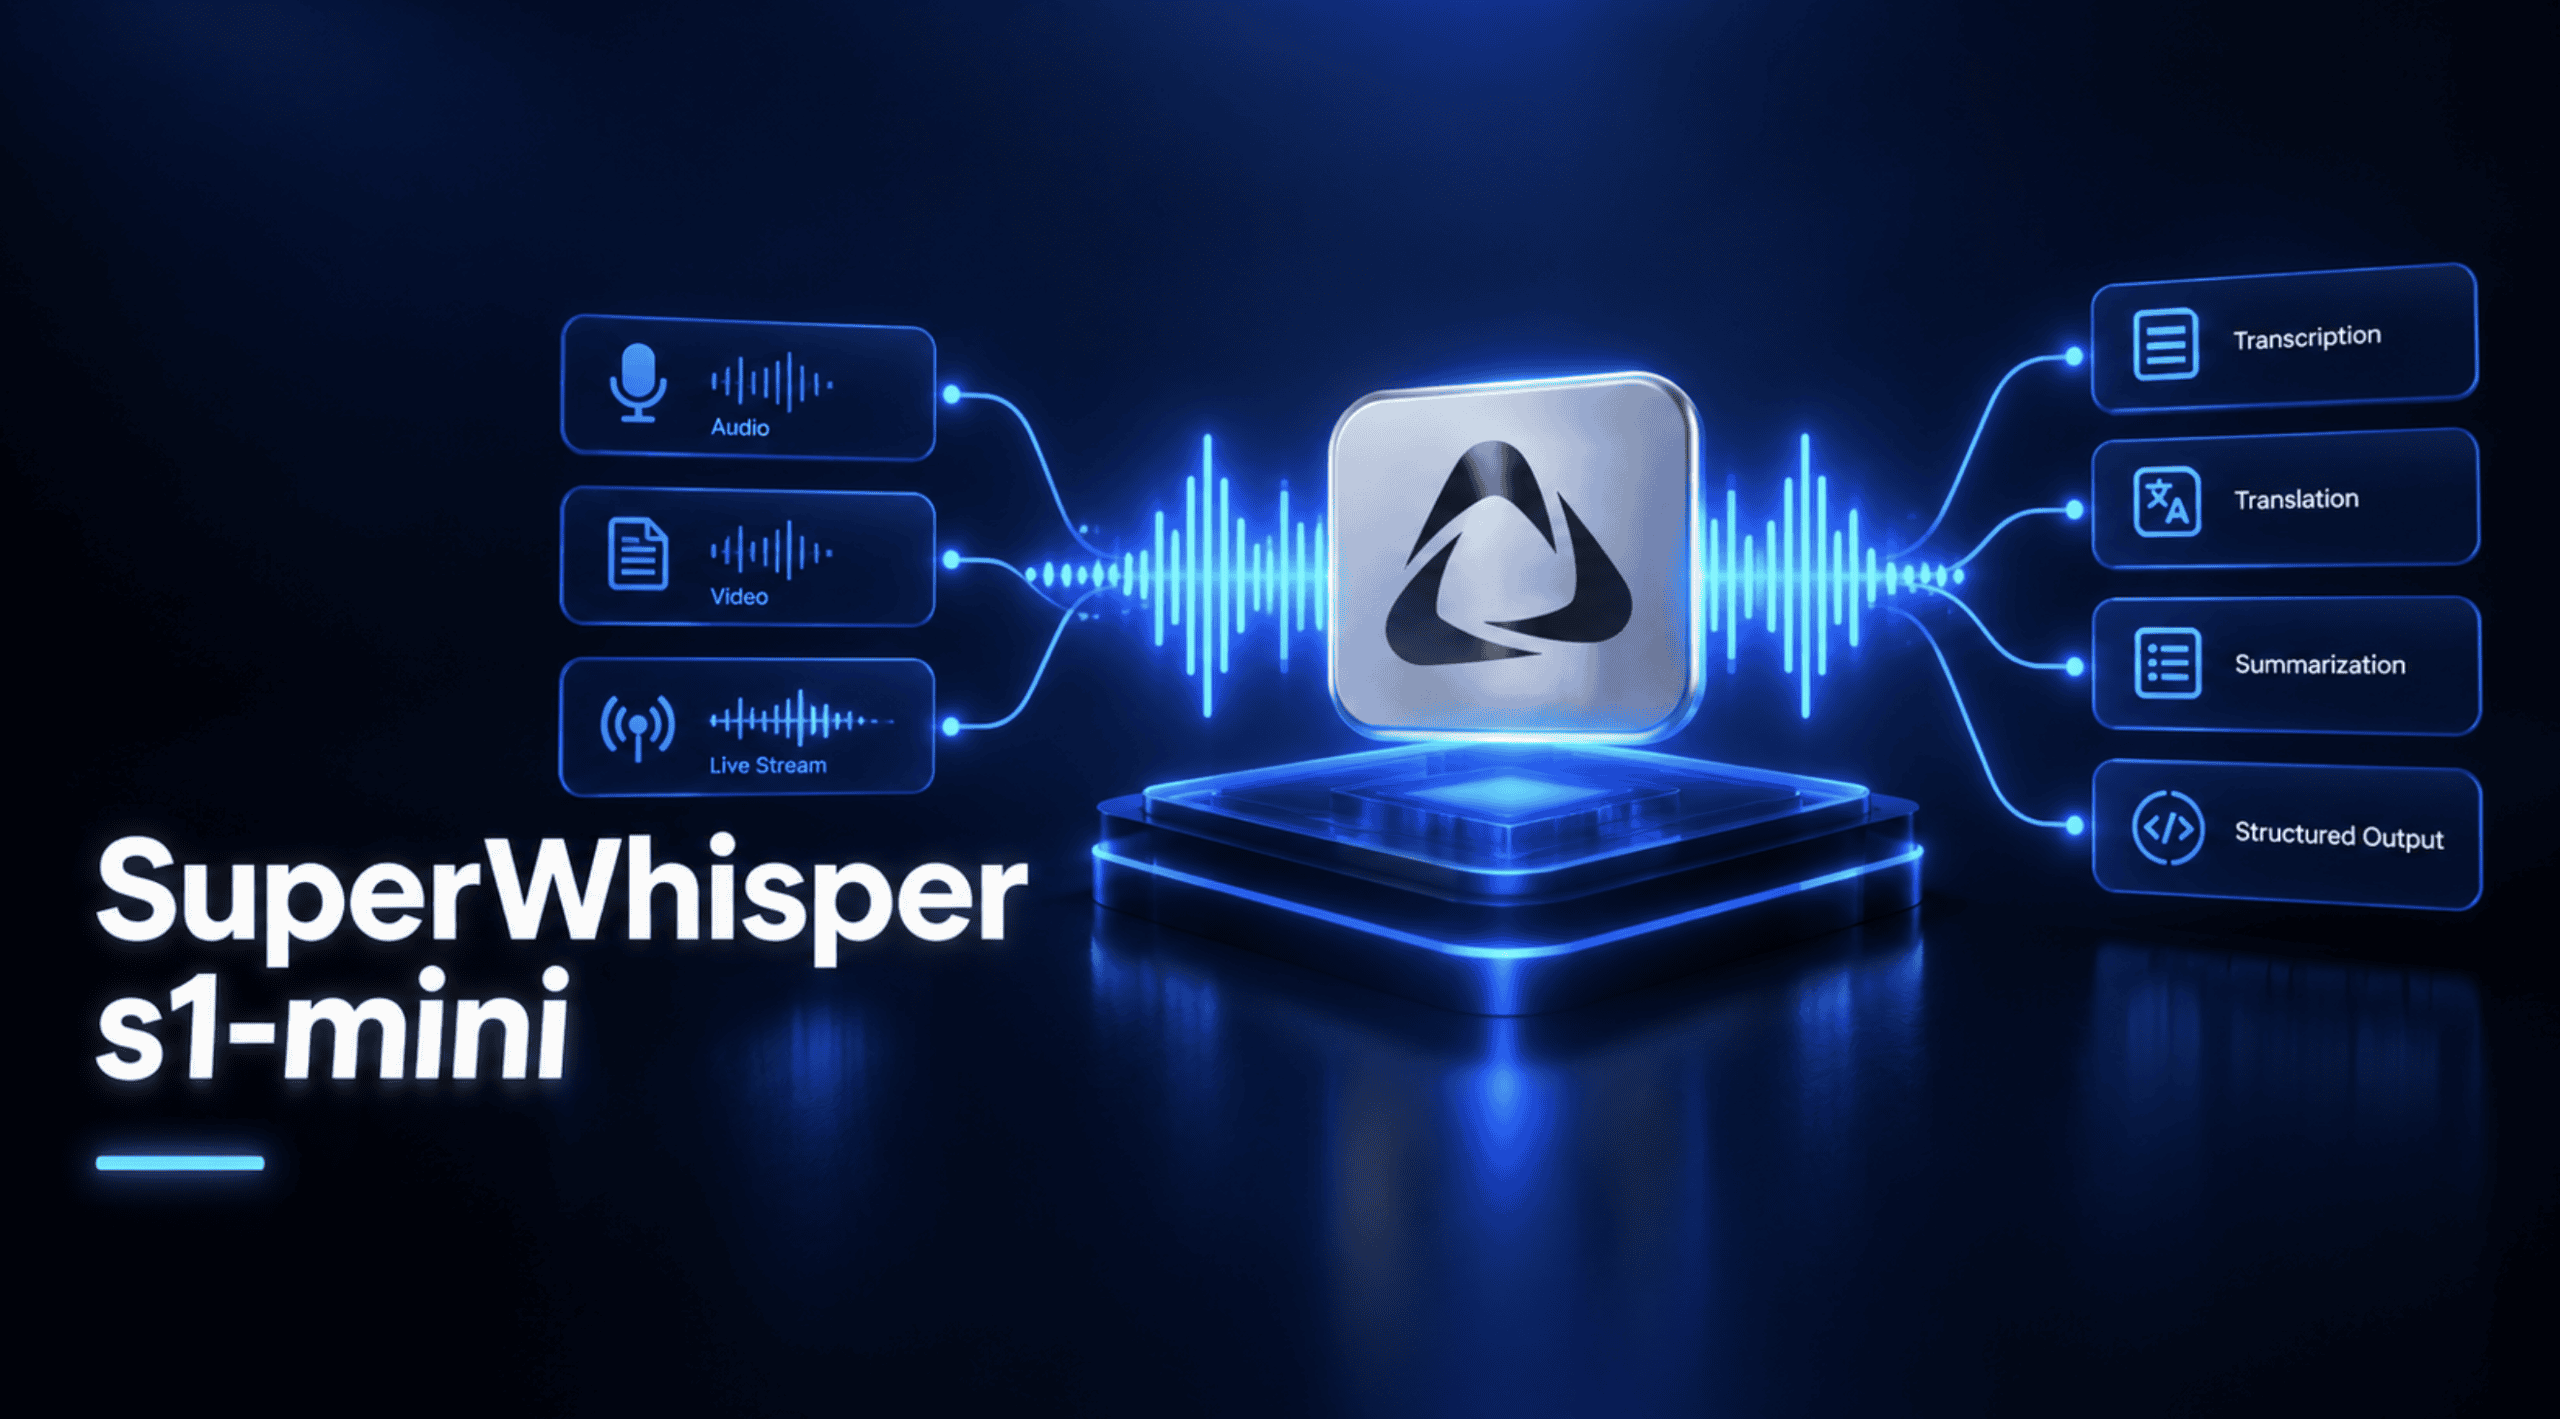
SuperWhisper ha publicado S1-mini, un modelo de 596 millones de parámetros con pesos abiertos que convierte una transcripción cruda de ASR en texto limpio y corre entero en la CPU de un portátil, sin GPU y sin hacer una sola petición de red. Forma parte de la familia S1 que la compañía presentó el 19 de agosto de 2026, junto a S1-Voice y S1-Language, los dos alojados en la nube y de código cerrado. Solo S1-mini tiene los pesos publicados, en su ficha de Hugging Face.
El detalle que deja el modelo mudo
S1-mini parte de Qwen3-0.6B, y de ahí hereda una trampa: la plantilla de chat de Qwen3 activa el modo de razonamiento por defecto. S1-mini se entrenó con ese modo explícitamente apagado y no tiene ni un rastro de razonamiento en sus datos. Si no se pasa enable_thinking=False, el modelo emite un bloque de pensamiento vacío y se detiene. Sin error, sin excepción, sin aviso: salida vacía. Es el fallo más habitual al integrarlo y conviene tenerlo memorizado antes de tocar nada.
El resto es una apuesta por la especialización. La ficha lo describe como "ruthlessly obedient": no añade contenido que no se haya dicho, no corrige hechos, no suaviza tacos, no reescribe el dialecto. Su único trabajo es limpiar. Se controla con una línea que se antepone a cada entrada y tiene tres ejes independientes: estilo (de informal a formal), estructura (prosa o listas, y solo pasa a viñetas cuando hay tres elementos reales) y contexto (general o correo, que activa el formato de saludo y despedida). Los tres se entrenaron por separado, así que cualquier combinación funciona.
Los números que da la compañía: sobre un conjunto reservado de 7.519 casos en inglés repartidos en 104 transcripciones, 94,8% de precisión por token y 11,6% de tasa de error de edición. En salida con formato de correo acierta la línea de saludo el 99,3% de las veces y la despedida el 97,9%. Menos del 1% de las generaciones muestran bucles o truncamientos, y ante una entrada que solo contiene ruido devuelve cadena vacía el 98,6% de las veces en lugar de inventarse texto.
Dónde encaja
La alternativa habitual es pasar el ASR por un modelo de chat general con un prompt de limpieza pegado, o tirar de un modelo local de 7B u 8B. S1-mini apuesta a que lo estrecho gana a lo general en esta tarea concreta: en una CPU de portátil, con una latencia y un consumo que un 7B no iguala. La propia SuperWhisper recomienda emparejarlo con un motor ASR local para quien trabaja sin conexión, y reservar S1-Language con S1-Voice para quien acepta la nube.
S1-Voice, por cierto, es el paso de audio a transcripción, y la compañía lo mide en ocho benchmarks con un 6,8% de tasa de error de palabras de media, el mejor de los 15 modelos que probó, y un 2,2% en LibriSpeech. Esas cifras son suyas, no de un tercero.
Que un modelo pequeño y aburrido haga una sola cosa puede sonar a poco. Pero la limpieza de transcripciones es el cuello de botella de cualquiera que monte dictado o actas automáticas, y aquí llega con pesos abiertos y sin depender de la nube.

