NVIDIA empuja el token por megavatio como métrica de las AI factories
La compañía presenta en el AI Infra Summit sus avances en DSX MaxLPS y Vera Rubin, con resultados de Lambda, Emerald AI y Pinterest como respaldo.
NVIDIA ha usado el AI Infra Summit de Santa Clara para mover el foco de sus AI factories: menos pico de rendimiento, más tokens por vatio. En el escenario, Ian Buck, vicepresidente de hyperscale y HPC, presentó las cifras de DSX MaxLPS y Vera Rubin y una lista de colaboraciones que incluye a Annapurna Labs (memoria HBM personalizada NVHBM), d-Matrix, que integra NVLink Fusion con sus XPU Raptor, y clientes como Lambda, Pinterest y Emerald AI. El evento ha pasado de 3.500 a más de 8.000 asistentes en un año.
El argumento de fondo es que la métrica de una AI factory ya no es el rendimiento pico, sino los tokens agénticos validados por megavatio. La carga agéntica encadena pasos de razonamiento y llamadas a herramientas, y eso castiga latencia y longitud de contexto. La respuesta de NVIDIA es un stack completo: sistemas Vera Rubin NVL72, software de inferencia Dynamo, librerías NeMo y red propia, con NVLink para scale-up, Spectrum-X Ethernet y ConnectX SuperNIC para conectar miles de nodos, y BlueField para almacenamiento de memoria de contexto y seguridad de la infraestructura.
Lambda valida el reparto dinámico de potencia
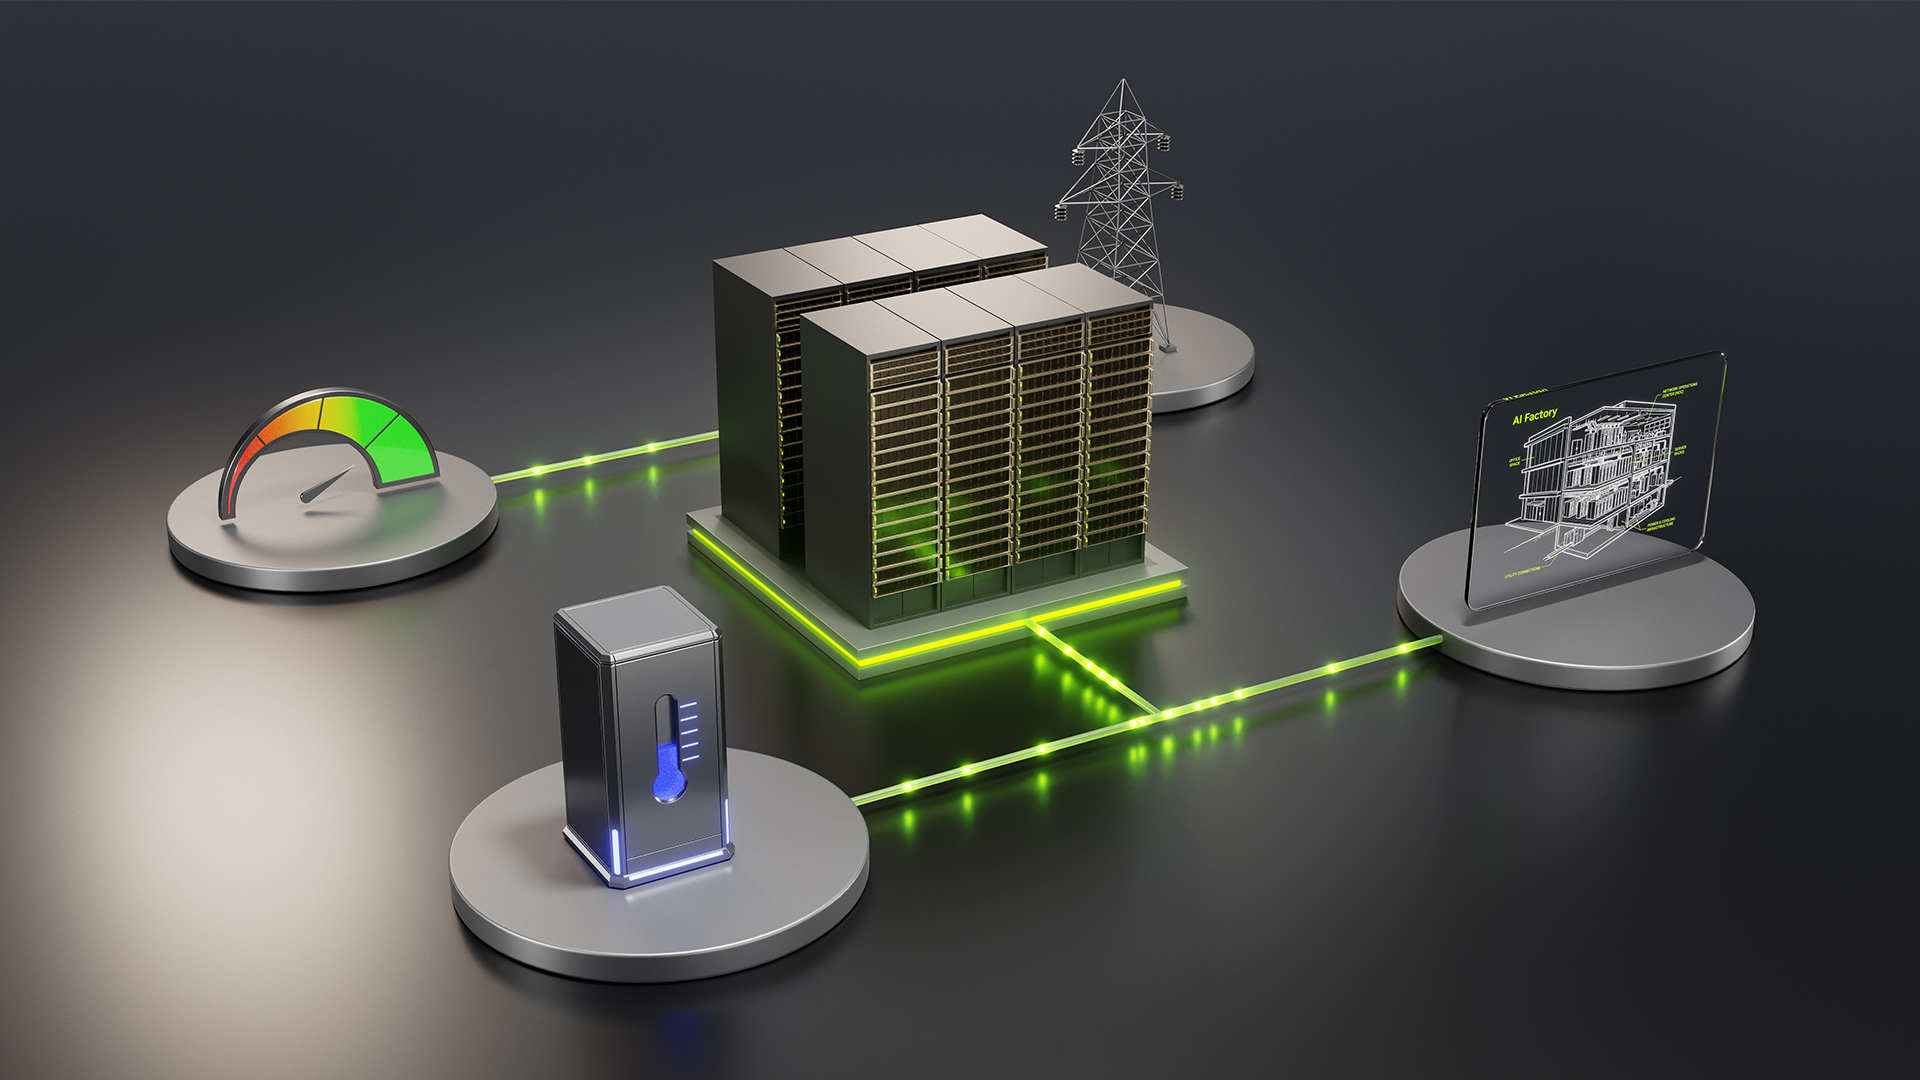
El caso más tangible es el de Lambda, que publicó la primera validación de DSX MaxLPS sobre servidores Blackwell. La herramienta vigila el consumo de GPU y racks, desplaza la potencia disponible a donde hace falta y recupera la capacidad que el reparto estático deja sin usar, algo que importa cuando conviven entrenamiento e inferencia con perfiles eléctricos distintos.
Los resultados de Lambda son concretos: metió 19 nodos en el presupuesto eléctrico que normalmente aguanta 16 a plena potencia, subió el throughput del clúster un 24% (de unos 4 a unos 5 millones de tokens por segundo) y mejoró el rendimiento por vatio un 23%. NVIDIA añade que, para las futuras Vera Rubin NVL72, MaxLPS puede habilitar hasta un 40% más de capacidad de GPU dentro del mismo megavatio en entornos de despliegue adecuados, y hasta un 35% más de throughput de tokens sin tender líneas nuevas. Ese matiz de los entornos adecuados es suyo, y no viene con desglose.
Carga flexible y latencia determinista
Emerald AI y Silicon Valley Power mostraron un programa de carga flexible: el sistema respondió a cientos de señales de demanda de la utility reduciendo potencia en trabajos no prioritarios y volviendo después a la normalidad, con DSX Flex como pieza de gestión. La idea es que una AI factory pueda comportarse como un recurso flexible de la red sin sacrificar los trabajos críticos.
Para el otro extremo, la latencia, NVIDIA presenta Groq 3 LPX como complemento de Vera Rubin: inferencia determinista de latencia ultrabaja que, según la compañía, entrega hasta 35 veces más tokens por megavatio que GB200 NVL72 en modelos de más de dos billones de parámetros.
Lo que queda por ver es cuánto de esto sobrevive al contrato de compra. Todo lo anunciado son cifras de NVIDIA o de partners que dependen de su plataforma, sin verificación externa, y el cuello de botella energético que dicen resolver no se mide en benchmarks sino en la factura eléctrica de cada sitio.