Cornelis levanta 205 millones para su red de interconexión de chips de IA
La empresa, escindida de Intel en 2020, cierra una ronda liderada por IAG Capital Partners y presenta Active Compute Fabric, una red abierta para aceleradores.

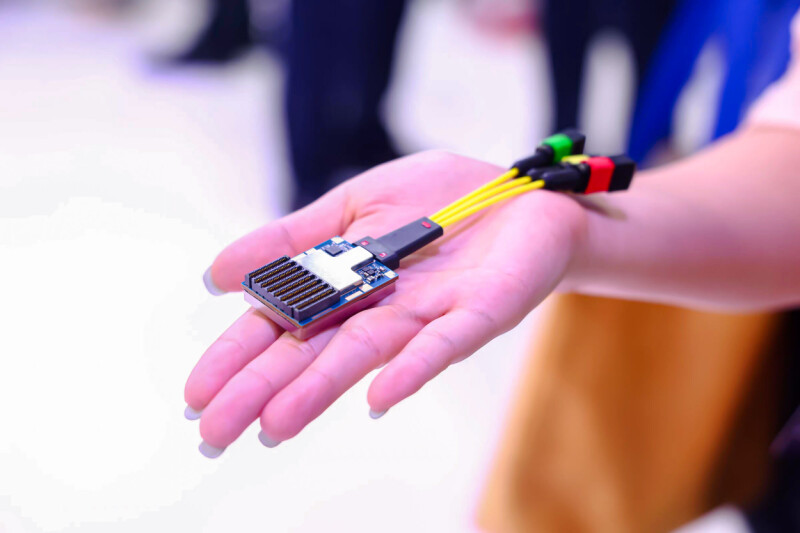
Cornelis ha levantado 205 millones de dólares en una ronda liderada por IAG Capital Partners. La compañía, que salió de Intel en 2020, vende una red de interconexión para que los aceleradores de IA se comuniquen sin perder tiempo, y ha presentado el producto que sostiene la apuesta: Active Compute Fabric.
El problema que ataca se mide fácil y se resuelve mal: buena parte del tiempo de una GPU se va esperando a que lleguen los datos. Cornelis propone una red que deja a los chips procesar y transmitir a la vez, en lugar de encadenar una operación detrás de otra. Es la misma familia de cuellos de botella que persiguen InfiniBand, NVLink y todo lo que ha crecido alrededor de los clústeres de entrenamiento.
Arquitectura abierta
Ahí está lo que la empresa quiere vender. Su propuesta es abierta: el cliente puede mezclar GPUs y aceleradores de distintos fabricantes sobre la misma red. Los chips de Nvidia pueden funcionar, en teoría, sobre otras redes, pero están optimizados para el software de la casa, y eso hace que tirar del stack completo resulte mucho más cómodo. Cornelis engorda la lista de compañías de infraestructura de IA que intentan romper ese dominio pieza a pieza. O chip a chip.
En el anuncio no hay cifras de rendimiento ni comparación con lo que ofrece Nvidia, así que por ahora lo que se vende es una arquitectura, no un resultado. Lo que sí dice la empresa es que el producto ya se está enviando y que trabaja en una generación nueva que debería salir antes de que acabe el año. De la valoración de la ronda no ha dicho nada, y el inversor principal es el único nombre que ha dado.
Qué implica para quien monta el clúster
La capa de interconexión se ha convertido en una decisión de compra tan pesada como la del propio acelerador. Si un tejido de red abierto cumple lo que promete, un equipo puede ampliar capacidad con hardware de varios proveedores sin rehacer el software de orquestación cada vez que cambia de generación. Si no lo cumple, se queda en un intermediario más entre la tarjeta y la aplicación.
Falta lo de siempre en este tramo: números de latencia y ancho de banda bajo carga real, qué topologías soporta, con qué frameworks y drivers se integra y si se puede meter en un clúster que ya está en producción sin reconfigurarlo entero. Cornelis ya vende, pero la comparación con el stack de Nvidia la tiene que enseñar ella, y todavía no lo ha hecho.