Cómo recortar el coste de inferencia de un SLM agrupando por longitud en vez de iterar
Ordenar las peticiones por longitud de tokens antes de formar lotes recorta el trabajo inútil del padding. La técnica se mide con Qwen2.5-0.5B-Instruct sobre un M2.
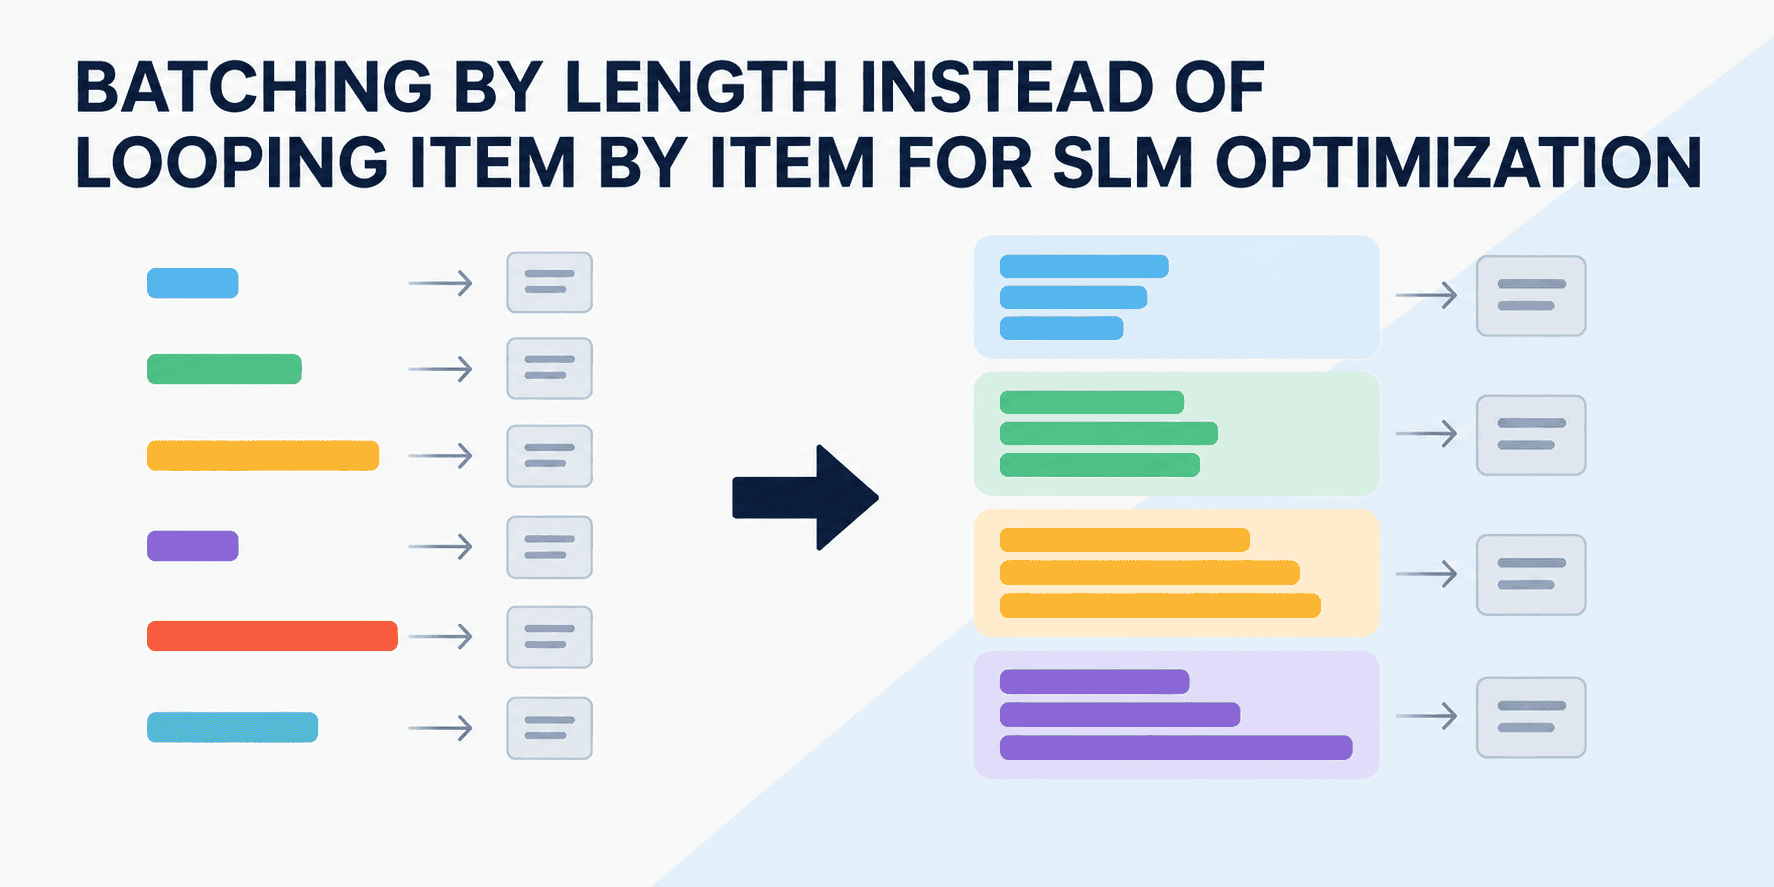
Procesar una petición por pasada es la mayor fuente de desperdicio de todo el pipeline. Esa es la tesis de la tercera entrega de la serie sobre automatización acotada con modelos pequeños: en lugar de recorrer los elementos uno a uno, ordenar por longitud de tokens y formar lotes de tamaño parecido.
El motivo es de hardware. Con tamaño de lote 1, un modelo de 500 millones de parámetros no está limitado por cómputo sino por ancho de banda de memoria: el sistema saca todos los pesos de memoria para atender una sola secuencia, y vuelve a hacerlo con la siguiente, con las unidades aritméticas casi paradas en medio. Agrupar amortiza esa lectura de pesos entre varias secuencias. Da igual si corre en GPU o en CPU, que es donde suele acabar un modelo de este tamaño.
Ahí asoma el segundo problema. Un lote obliga a rellenar con padding hasta una longitud común, y el texto real tiene cola larga: si el elemento más largo ronda los 449 tokens y la mediana se queda en 94, rellenar cada lote hasta el máximo global significa calcular sobre todo padding. En la distribución de prueba, 600 tickets sintéticos de entre 48 y 449 tokens, el propio script calcula que se procesarían 3,7 veces más tokens de los necesarios. La solución que propone el artículo es ordenar por longitud antes de agrupar, de modo que cada lote se rellene hasta su máximo local y no hasta el global.
Lo que hay que tocar en el código
El ejemplo usa Qwen2.5-0.5B-Instruct con Hugging Face Transformers y hereda la puntuación restringida de las entregas anteriores: el modelo no genera texto, solo elige entre tres etiquetas (billing, technical, account) mirando el logit de la primera posición. El script comprueba con un assert que ninguna pareja de etiquetas comparte el primer token, porque en ese caso habría que puntuar la secuencia completa.
Tres detalles de implementación que menciona el autor: asignar el token de padding al token de fin de secuencia, poner padding_side a la izquierda para que el último token real quede en el índice -1, y pedir únicamente el logit de la última posición (logits_to_keep o num_logits_to_keep, según la versión instalada). Sin eso, un lote de 32 por 400 tokens devuelve un tensor de logits de varios gigabytes que se descarta de inmediato.
Las pruebas corren en un M2 MacBook Air con 24 GB de RAM, 16 núcleos de Neural Engine y 600 tickets generados con una lognormal truncada. En el bucle secuencial, el progreso que imprime el propio script marca unos 0,23 segundos por elemento.
El texto no llega a mostrar el total del bucle item a item —la salida se corta en el ticket 400 de 600— ni el tiempo del loteo ordenado, así que la comparación final hay que medirla en cada casa. Tampoco cuadra del todo la precisión: la cabecera habla de float16 y el listado carga el modelo en float32. Aun así el patrón es aplicable a cualquier cola de trabajo por lotes, y la parte de ordenar por longitud no depende del modelo ni del hardware.