Xiaomi publica MiMo-V2.6-Pro, el mayor modelo de pesos abiertos hasta ahora
Tiene 1,02 billones de parametros totales, 42.000 millones activos, sale bajo licencia MIT y lidera el indice de inteligencia de Artificial Analysis entre los modelos abiertos.
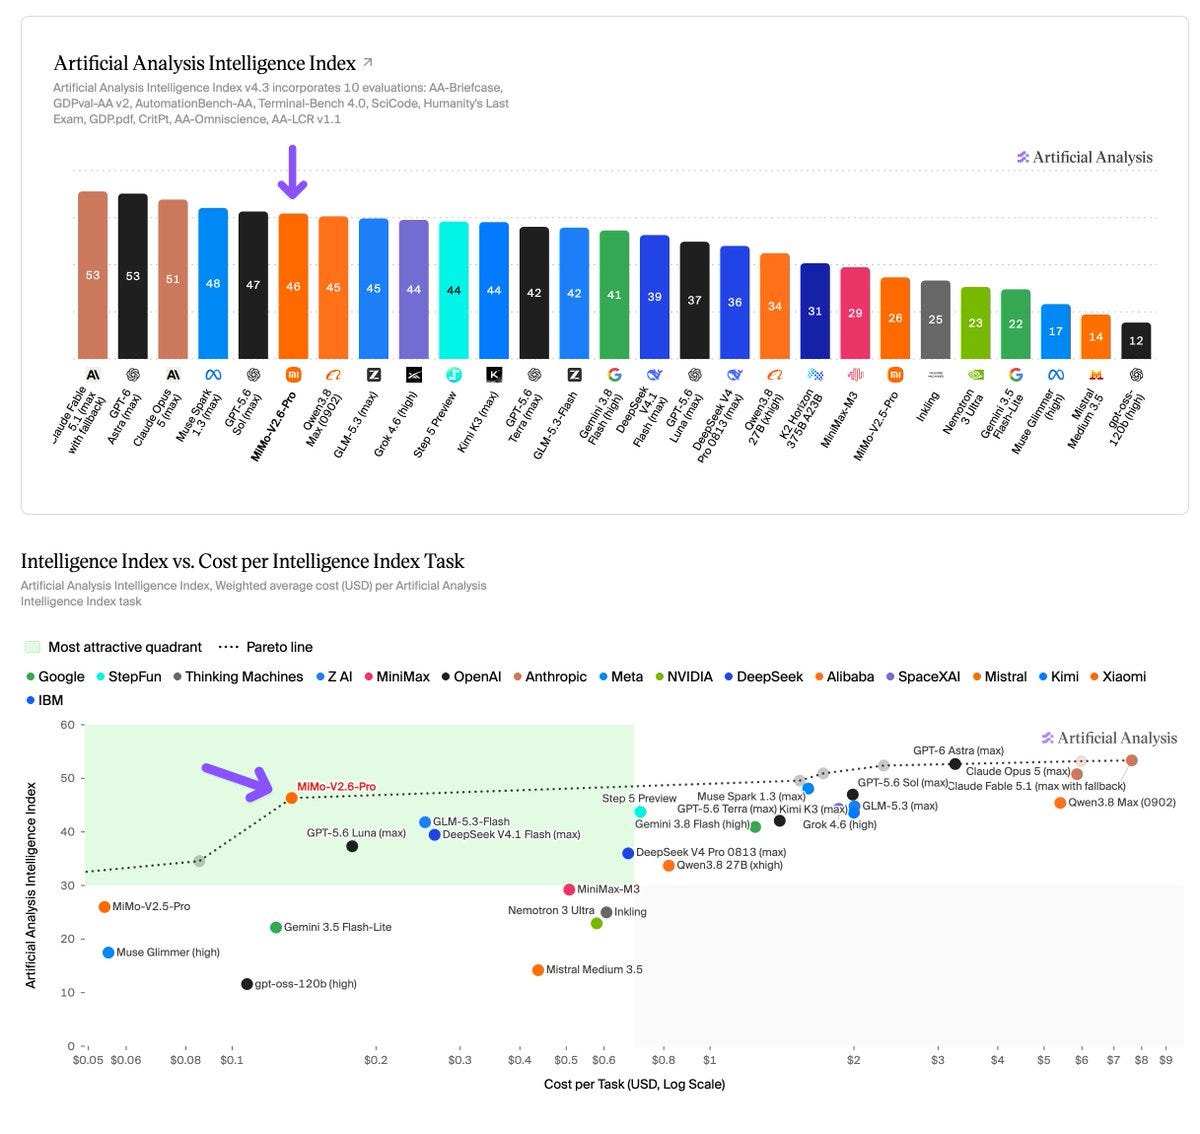
Xiaomi ha publicado MiMo-V2.6-Pro y MiMo-V2.6-Flash, dos modelos omnimodales nativos de pesos abiertos. El grande debuta como el mejor modelo abierto en el Intelligence Index de Artificial Analysis, con 46 puntos, y llega acompanado de informe tecnico, entornos de entrenamiento por refuerzo y codigo.
Xiaomi no suele aparecer en la lista de los seis tigres chinos de la IA, asi que el resultado descoloca un poco el orden de nombres al que uno esta acostumbrado. El modelo es un MoE de 1,02 billones de parametros totales y 42.000 millones activos. Los precios que se han publicado son 0,435 dolares por millon de tokens de entrada y 0,87 por millon de salida, con un coste de 0,13 dolares por tarea del indice, lo que lo coloca en la frontera de Pareto entre inteligencia y coste por tarea. Hay ademas una variante Pro-UltraSpeed que promete hasta 20 veces mas velocidad de generacion con la misma calidad.
El entrenamiento es la parte interesante
El informe tecnico detalla como se escalo el computo de RL en tres ejes. Por un lado, lotes grandes sobre una arquitectura completamente asincrona, con 1.568 muestras por actualizacion, contexto de hasta 1M de tokens y entre 3.500 y 3.700 millones de tokens por paso. Por otro, mas tareas y entornos mas ricos: codigo, agentes generales, visual y ciberseguridad, mezclados en distintos arneses para que la mejora en una capacidad arrastre a las demas. Y por ultimo, mas computo dedicado a evaluar, comparando dentro de cada grupo para dar senales de recompensa mas precisas en tareas de horizonte largo y empujar al modelo hacia caminos mas cortos.
Las cifras que se han citado para esa fase son 130 horas, 75.000 millones de tokens y 2,6 millones de dolares, con el apilado corriendo sobre JAX y TPU, donde escalar es sobre todo un cambio de configuracion y no una reescritura de codigo. El equipo venia publicando en abierto sus ejecuciones finales de RL, algo que no es habitual en un laboratorio de este tamano.
La liberacion incluye el modelo, las recetas de codigo y sus recompensas, un entorno ARVO para reproduccion de vulnerabilidades, un entorno de desarrollo web, preparacion de datos y evaluador de musica, y los adaptadores de entorno de mimoagent. Los conjuntos de datos completos, mas de 7.000 tareas, todavia no se han publicado.
Que los entornos de RL abiertos pesen tanto como pesaron los corpus de preentrenamiento en el ciclo anterior es la lectura que mas se repite entre quienes han mirado el lanzamiento. Si esas cifras de coste se sostienen, la fase de post-entrenamiento deja de ser el pariente caro del preentrenamiento y pasa a ser la via barata para acercarse a la frontera. Queda por ver si los datasets aparecen y si alguien reproduce el entrenamiento completo fuera de Xiaomi.

