Una instrucción SVE2 promete acelerar simdjson en procesadores ARM
Un ingeniero de ARM lleva al parser la idea que Daniel Lemire planteó en abril: clasificar los caracteres estructurales del JSON con la instrucción match de SVE2 en lugar de con NEON.
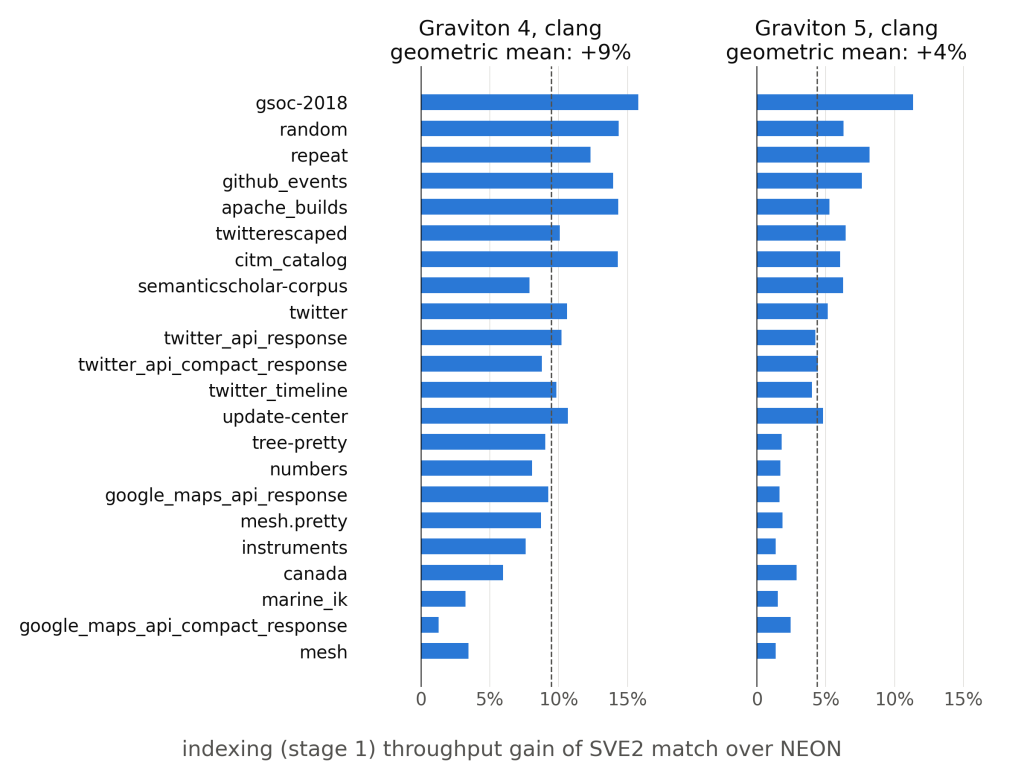
Madhurendra Purbay, ingeniero en ARM, ha mandado un pull request a simdjson para sustituir el clasificador de caracteres estructurales del parser por uno construido sobre la instrucción match de SVE2. Daniel Lemire, una de las cabezas detrás de la librería, había dejado la idea en abril sobre una prueba de juguete y con una pregunta abierta: si eso sobrevive al contacto con un parser de verdad. El PR es la respuesta, y de paso enseña dónde se atasca el SVE2.
De dónde viene el clasificador actual
La versión ARM de simdjson usa NEON, el SIMD clásico. Cada 16 bytes pasan por una búsqueda en tabla: al byte se le suma 3, se conserva el nibble alto y se consulta una tabla de 16 entradas que devuelve el carácter estructural que corresponde a ese nibble, o 0xff si no hay ninguno. Si el valor consultado coincide con el byte original, ese byte es estructural. Son cuatro intrínsecos —vaddq, vshrq, vqtbl1q y vceqq— por cada 16 bytes, y el resultado son bytes a 0x00 o 0xff.
Convertir cuatro de esos vectores en una máscara de 64 bits cuesta unas ocho instrucciones más por bloque de 64 bytes: hay que aplicar pesos de bit con un AND y sumar bytes adyacentes con addp. Ese paso se comparte con la máscara de espacios en blanco, así que no se paga dos veces.
Lo que aporta match
svmatch_u8 toma un vector de bytes y un segundo vector que actúa como conjunto de hasta 16 elementos, dentro de segmentos de 128 bits, y devuelve un predicado con un bit por cada posición que coincide. Los seis caracteres estructurales de JSON caben de sobra. NEON no tiene nada parecido; en x64 lo más cercano son las pcmpistrm de SSE4.2, que son lentas.
El problema es la salida. El predicado vive en un registro de predicados y la arquitectura no ofrece una forma barata de llevarlo a un registro de propósito general, porque no asume que la máscara quepa en 16 bits. Toca materializarlo como bytes con svsel y pesos, recuperarlo con svget_neonq_u8 —parte del puente NEON-SVE— y sumar. La instrucción match se queda en una; el trasiego de la máscara se lleva el resto. El cuello de botella se ha movido del emparejamiento a la extracción del resultado, que es justo lo interesante del caso.
Un detalle que ayuda: en SVE los primeros 16 bytes se comparten con NEON, así que el svset_neonq_u8 que mueve los datos y la tabla probablemente compile a nada.
Para medirlo, Lemire compara el clasificador con match contra el de NEON usando el banco de pruebas parse que viene con simdjson, sobre los 22 ficheros del corpus habitual —unos 24 MB en total— con 300 pasadas por archivo. Los resultados y los scripts están publicados en su repositorio.
Que una instrucción de una generación nueva ahorre trabajo en el bucle más caliente del parser no se traduce solo en velocidad si sacar el resultado cuesta caro. SVE2 no está en los chips de Apple, pero sí en procesadores ARM de nube, y simdjson es hoy el parser de referencia en bastantes stacks, así que el patrón que salga de aquí se repetirá en el resto del código que intente exprimir SVE2.

