Un desarrollador construye una app de iOS funcional en cuatro días con Opus 5.5
El informe detalla el uso de Claude Code, la planificación con agentes y cómo un benchmark interno elevó la precisión del 80% al 99%.
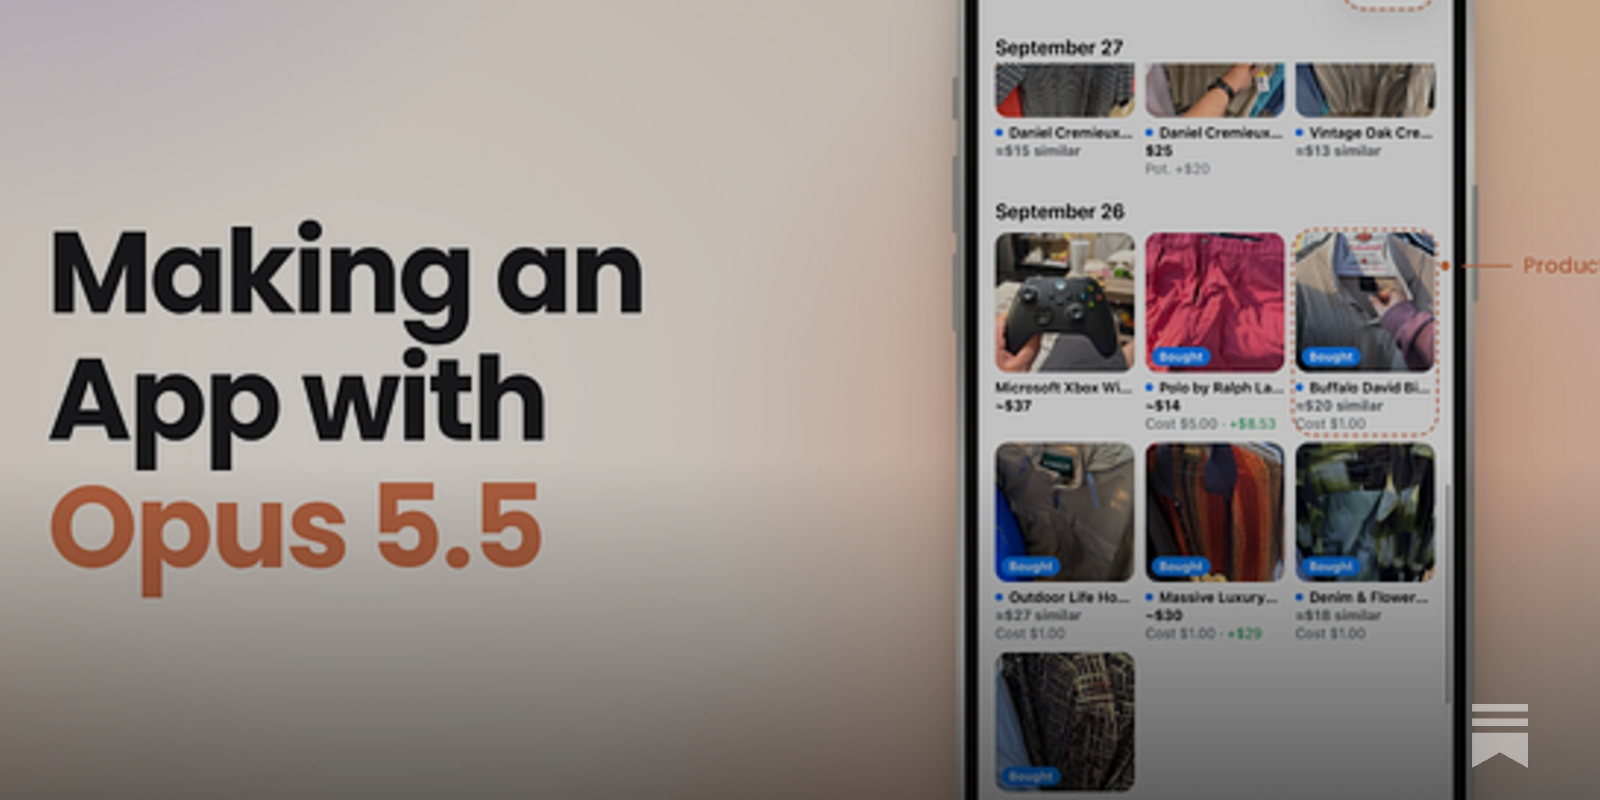
Un ingeniero de software ha publicado los detalles de cómo desenvolvió una aplicación para iPhone en cuatro días utilizando Claude Opus 5.5 de Anthropic. La herramienta, diseñada para el negocio de reventa de su pareja, utiliza visión por computadora para identificar productos a partir de fotos y estimar su precio de mercado cruzando datos de eBay, Mercari y otras plataformas. El desarrollo se apoyó en la infraestructura de Expo con React Native para el frontend y Supabase para la base de datos y el backend.
El proceso comenzó con una sesión de planificación de dos horas donde el autor definió los flujos de usuario y las decisiones técnicas clave, generando un documento que sirvió de guía para el agente. Según el narrativo, este plan documentado evitó que el modelo inventara requisitos en tiempo de ejecución y facilitó la coordinación de subagentes, que podían validar su trabajo contra el esquema global. El desarrollo principal se realizó con Claude Code en modo automático, que generó aproximadamente 8.000 líneas de código en dos horas. Aunque la primera versión funcionó, el reconocimiento de objetos y el emparejamiento de precios requerieron ajustes.
La refinación se llevó a cabo mediante grabaciones de voz de cinco minutos donde el desarrollador describía los problemas visuales y de interacción. El agente transcribió el audio, hizo preguntas de aclaración y implementó los cambios en una hora y media. La fase crítica llegó al depurar el algoritmo de búsqueda: el modelo identificó errores en la lógica de bases de datos y diseñó su propio benchmark con 33 fotos reales. Esta validación interna redujo los resultados erróneos del 19% al 1% y elevó la precisión general del 80% al 99%, una mejora que el autor atribuye a la capacidad del modelo para autotestearse.
El caso resalta la tendencia de los modelos de frontera a abaratar costes mientras mejoran en tareas agénticas. El autor señala que Opus 5.5 supera a Fable 5.1 en benchmarks agénticos a un precio de API inferior, manteniendo presiones competitivas de modelos de pesos abiertos como GLM-5.3 y DeepSeek v4.1 Flash. La lección operativa para equipos de TI es clara: la supervisión humana sigue siendo necesaria para definir el 'qué' y validar el 'cómo', pero la ejecución y el debug de sistemas complejos pueden delegarse significativamente.
Este tipo de flujos de trabajo reduce los tiempos de prototipado de meses a días, siempre que la infraestructura subyacente, como Supabase, ofrezca una abstracción suficientemente robusta para que los agentes cometan menos errores de configuración. La fiabilidad del resultado final depende menos de la mágia del modelo y más de la calidad del plan inicial y de los benchmarks de validación que el desarrollador le permita ejecutar.