Uber rediseña el sharding de M3DB con subclusters para acotar el impacto de los fallos
La base de datos de series temporales pasa a repartir los nodos en subclusters de tamaño fijo, cada uno dueño de una porción distinta del espacio de shards, para que un fallo no arrastre a media base de datos.
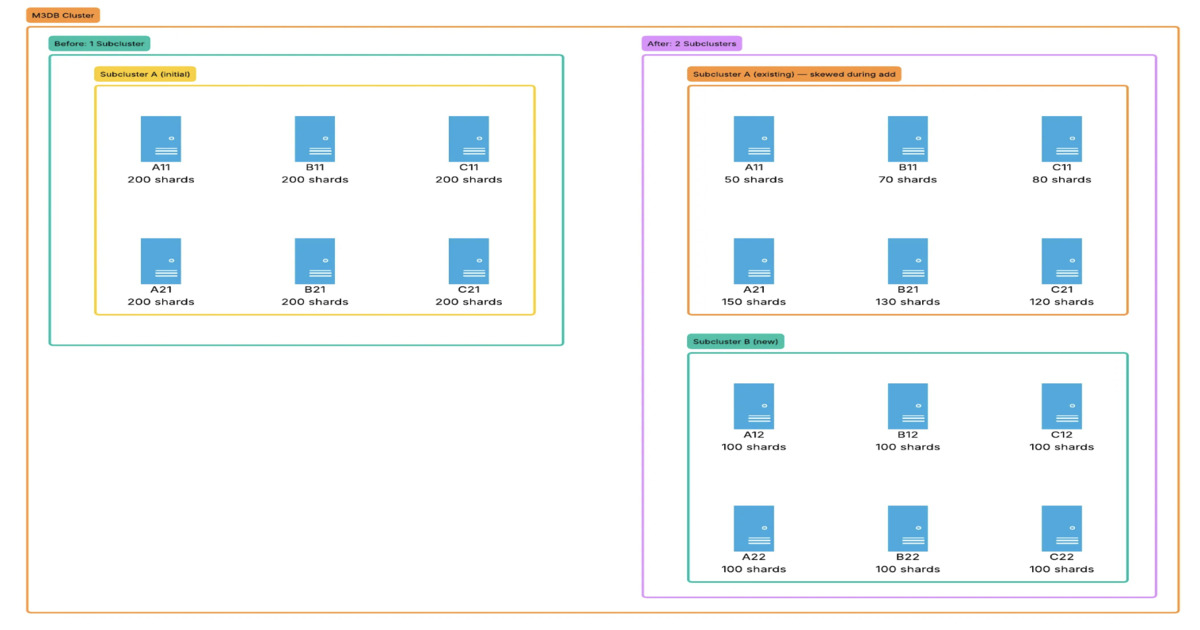
Uber ha cambiado la forma en que M3DB reparte sus shards. El nuevo modelo divide los nodos en subclusters de tamaño fijo, cada uno propietario de una porción distinta y sin solapamiento del espacio de shards, con el objetivo de que el fallo de un nodo, una ventana de mantenimiento o un escalado no arrastren a media base de datos.
M3DB es la base de datos distribuida de series temporales de Uber. Los datos se parten en shards y se replican entre varios nodos, y el algoritmo de colocación decide quién es dueño de cada shard mientras garantiza que las réplicas no caigan en el mismo grupo de aislamiento: racks o zonas de disponibilidad distintas.
Qué fallaba en el modelo anterior
El esquema clásico funcionaba bien en clusters pequeños y medianos, pero se volvía difícil de operar según crecía la instalación. Cualquier nodo podía ser dueño de un shard siempre que sus réplicas no compartieran grupo de aislamiento. En una configuración permisiva eso genera un grafo de dependencias en el que un cambio de topología afecta a O(N) nodos. Incluso con tres zonas y un factor de replicación de tres, un nodo puede acabar compartiendo datos con hasta el 66,67% del cluster. Más actividad de recuperación y operaciones de mantenimiento que hay que serializar.
Con el nuevo diseño, un cluster de 12 nodos con factor de replicación tres y seis nodos por subcluster queda partido en dos subclusters, cada uno con la mitad de los shards. Dentro de cada subcluster, M3DB sigue repartiendo las réplicas entre grupos de aislamiento como antes.
El escalado consiste en mover shards desde los subclusters existentes a uno nuevo. Uber usa un algoritmo greedy que evalúa qué pasa si se quita cada shard candidato del subcluster donante y elige los que dejan los nodos restantes lo más equilibrados posible. Así evita una segunda pasada de rebalanceo y el tráfico de red y el trabajo de bootstrap que supondría mover los shards dos veces. El coste es O(S log S) en ordenación y O(S × N) en simulación, donde S son los shards candidatos y N los nodos del subcluster.
Los límites del enfoque
No sale gratis. Exige pesos de instancia iguales, escalar en múltiplos del tamaño de subcluster y que ese tamaño sea múltiplo del factor de replicación. Tampoco permite cambiar el factor de réplica mediante AddReplica. Durante el escalado puede haber compartición temporal de shards entre subclusters, y solo se admite un subcluster parcial a la vez.
Uber mantuvo las operaciones de colocación a nivel de instancia en lugar de introducir operaciones atómicas de subcluster. La razón que dan sus ingenieros es la compatibilidad con las herramientas que ya existen y evitar un bootstrap masivo en el que migren muchos shards a la vez. La implementación de colocación incluye ahora campos para el modo subclustered y para el número de instancias por subcluster.
Para quien opera M3DB, el cambio toca directamente cuánto se tarda en recuperar un nodo caído y cuánto margen hay antes de tener que tocar la topología. El proyecto es open source, así que el código está en el repositorio de m3db y el modelo de colocación sigue documentado en la guía de placement. Queda por ver si esas restricciones de escalado en múltiplos se relajan en versiones posteriores o si se quedan como precio fijo del diseño.