Opus 5.5 arrasa generando vídeo con código y lidera el gasto en OpenRouter
El modelo de Anthropic se ha hecho con la cuota de gasto y de tokens dentro de su familia en OpenRouter una semana después de salir, y el dial de esfuerzo regala una curva incómoda.
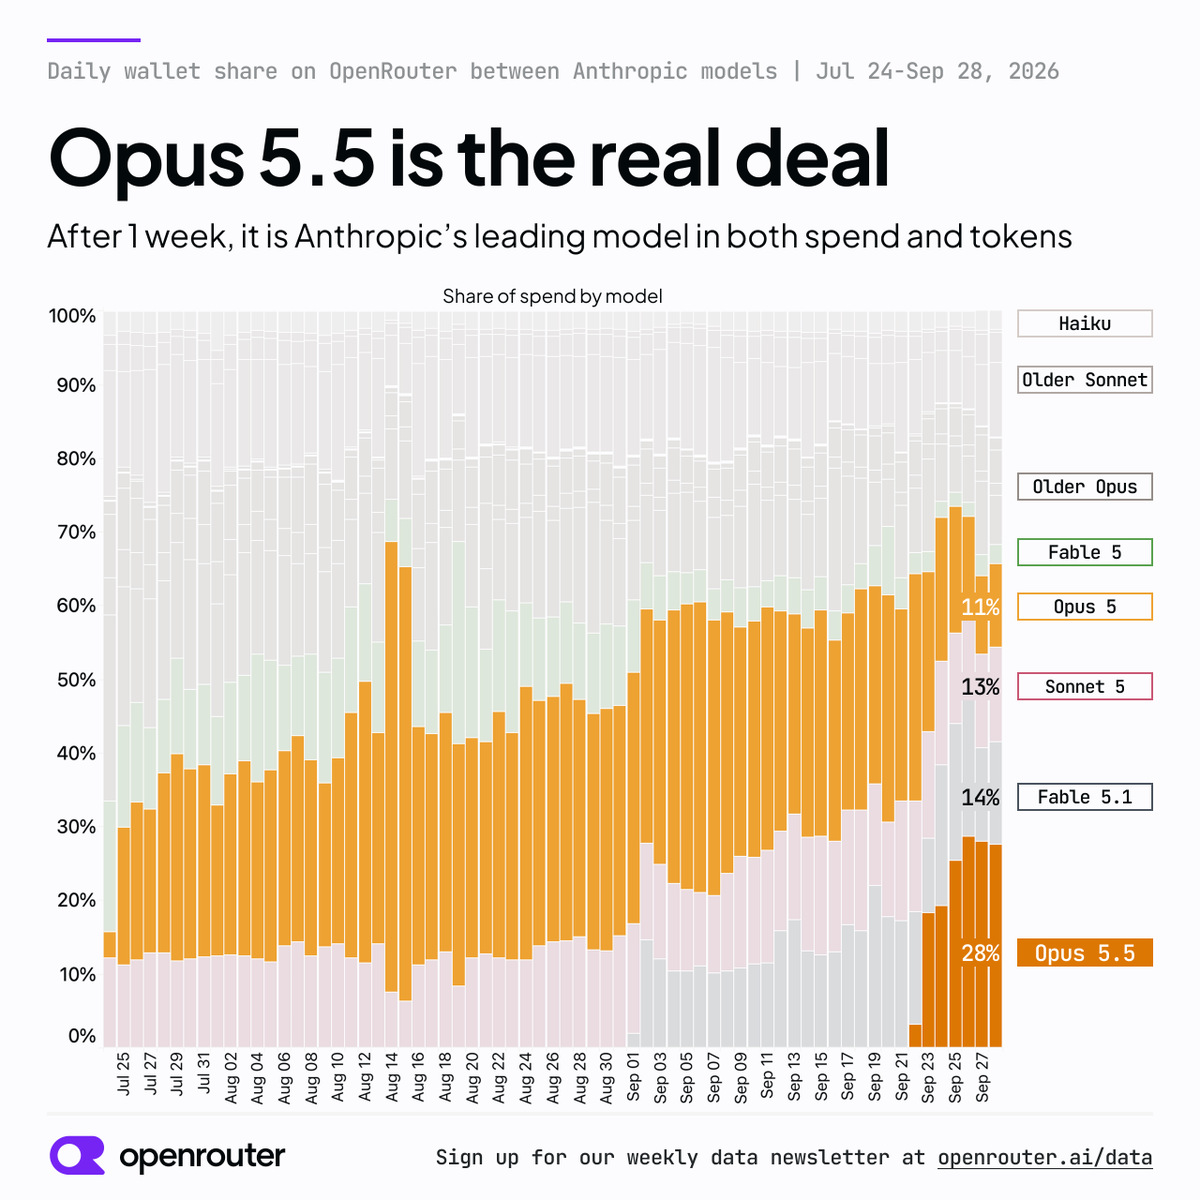
Casi todo lo que ha circulado en torno a Opus 5.5 desde su lanzamiento son vídeos, no tablas de benchmarks. En X se han acumulado piezas de motion design de 15 segundos generadas enteramente con código, sin After Effects de por medio, y OpenRouter confirma que ya es el modelo de Anthropic con mayor cuota de gasto y de tokens en su plataforma. El salto desde Opus 5 ha sido rápido.
El vídeo más citado salió de un prompt que su autor enseñó tal cual. Es este:
make a dynamic 15-second motion graphics video that shows what an incredible motion designer you are, like it's your showreel for a résumé. go all out.
Que el modelo escriba código que renderiza una animación no es nuevo. Lo que ha cambiado es la calidad del resultado en una sola pasada, y ahí la conversación se ha desmandado. Conviene desconfiar de las comillas: quien revisó varios de esos vídeos encontró un flujo de trabajo con estados de UI intermedios, más cerca de dirigir al modelo que de dejarlo suelto. Tyler Shukert repitió la prueba contra Supabase y dice que el resultado aguanta.
El dial de esfuerzo se atasca al final
Los datos duros llegan sobre todo de evaluaciones sueltas. En SimpleBench encabeza con un 88,4%. En Terminal-Bench-Science sube del 24% con esfuerzo bajo al 62% con xhigh, y luego cae al 59% en max. Hay quien recomienda evitar max justamente por eso: impone un presupuesto mínimo de razonamiento y sale más caro para peor resultado. En visión, quien lo ha rankeado lo coloca por delante de Fable 5 y GPT-6 Sol, por detrás de GPT-6 Astra, y a un 60% menos de coste que Fable 5.1.
El resto de la semana ha venido cargado. Gemini 3.8 Flash da 41 en el índice de AA a 291 tok/s con un millón de tokens de contexto, es gratis en Cline y en ARC-AGI marca 89,2% en v2 a 0,40 dólares por tarea. Xiaomi ha publicado MiMo-V2.6-Pro bajo licencia MIT, omni-modal y con el mismo contexto de un millón; saca 46 en ese índice frente a los 47 de GPT-5.6 Sol, a 0,13 dólares por tarea contra 1,99. También ha liberado el código de su RL y los entornos de entrenamiento, algo poco habitual.
Jev, el juez barato
TypeSafe levanta más de 1.000 millones a una valoración por encima de 10.000 millones, una semana después de cerrar otra ronda de 200 millones. Su modelo Jev no devuelve texto razonado, sino decisiones tipadas con probabilidades. En el paper de Jev-as-a-Judge sale a 0,044 dólares por cada 1.000 juicios con 152 ms de latencia mediana, unas 277 veces más barato que GPT-6; se queda a 3 puntos en RewardBench y HaluEval, pero pierde 14,5 en JudgeBench. La receta que proponen es una cascada que escala los casos de baja confianza a Astra: mantiene el 99% de la precisión al 57% del coste. Las evaluaciones están publicadas en el repositorio de referencia.
Como alternativa, CLM es un modelo contrastivo que incrusta la situación y las acciones candidatas y las ordena: va unas nueve veces más rápido que Jev y verifica mejor a largo plazo. Ramp igualó la precisión de reranking de GPT-5.6 Luna con diez veces menos latencia de cola (300 ms) y un tercio del coste, y Jev demostró 140 teoremas de Software Foundations por menos de un dólar.
El listón de esta semana no está en cuál escribe mejor, sino en cuánto cuesta cada token cuando el modelo se equivoca poco y el dial de esfuerzo se puede bajar sin perder lo esencial. Ahí es donde se decide la factura de quien tiene que enrutar inferencia a producción.


