OpenAI enseña el ASIC de inferencia Jalapeño y cómo la IA acortó su diseño
La compañía publica la conversación con su vicepresidente de hardware sobre un chip presentado en Hot Chips, diseñado en un plazo muy corto con ayuda de IA. Sin cifras de rendimiento ni calendario.
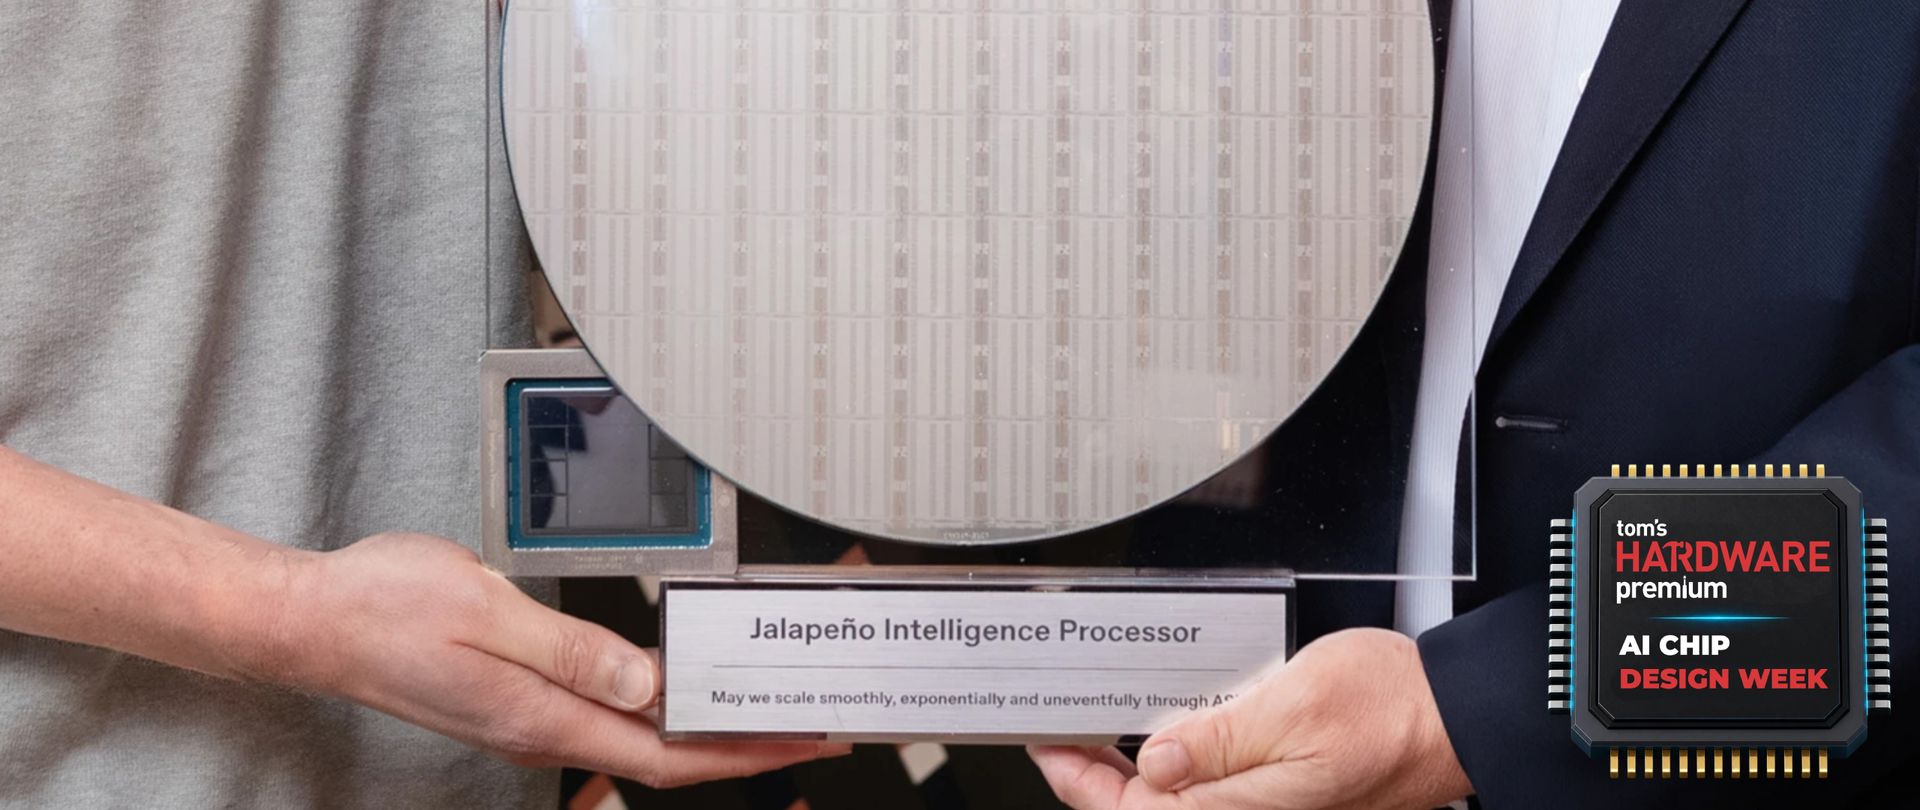
OpenAI ha dado más contexto sobre Jalapeño, el ASIC de inferencia que presentó en Hot Chips en agosto de 2026. El chip se diseñó en una ventana muy corta y con un peso notable de la IA dentro del propio proceso de diseño, según la conversación con Richard Ho, vicepresidente de hardware de la compañía.
Lo nuevo no es el chip: eso ya se vio en la conferencia. Lo que se ha publicado ahora es la transcripción de esa entrevista, y ahí está el interés para quien sigue el silicio de inferencia. Hot Chips es el foro donde los fabricantes enseñan el die, los números y las decisiones de arquitectura, y una presentación sin transcripción detrás suele dejar la mitad de la historia fuera. El material está disponible sin coste por tiempo limitado, lo que da una idea de por dónde va el negocio de quien lo publica.
Qué hay y qué no
De momento hay poco material técnico. La conversación con Ho gira alrededor de cómo se usó IA para acortar el ciclo de diseño y de hacia dónde puede ir esa práctica en el desarrollo de silicio a medida. Eso es lo que cuenta el entrevistado, y es también lo más interesante del asunto: no el chip en sí, sino el método con el que se llegó a él.
No hay cifras de rendimiento en este material, ni consumo, ni nodo de fabricación, ni memoria, ni qué formatos numéricos o aceleradores soporta. Tampoco aparece un cliente ni un calendario de disponibilidad. Y conviene recordar de quién viene la afirmación de que la IA apretó los plazos: de la empresa que ha diseñado el chip. Ese tipo de dato se comprueba con la máscara final y con las fechas de tape-out, y aquí no tenemos ninguna de las dos.
Por qué importa
OpenAI diseñando su propio ASIC de inferencia es la señal que el sector lleva tiempo esperando. Los precedentes están en las nubes: Google lleva años con sus TPU y AWS con Trainium e Inferentia, y quien entrena y sirve modelos a gran escala tiene incentivos para bajar el coste por token fuera del catálogo de un tercero. Si además el diseño asistido por IA demuestra que un equipo más pequeño saca un chip en menos tiempo, el cuello de botella deja de estar en la arquitectura y se mueve a la capacidad de fabricación.
Para quien administra infraestructura, la consecuencia práctica llega más tarde y por la vía del precio: menos coste por inferencia donde se despliegue este tipo de silicio y más presión sobre lo que cuesta alquilar GPUs por horas. Hasta que aparezcan números medibles, eso es una expectativa y no un dato.


