Jev renuncia al chat: respuestas de sí o no, rápidas y baratas para decidir
TypeSafe AI ha lanzado un modelo que no conversa: solo elige entre opciones, ordena y devuelve probabilidades. En una semana se ha vuelto viral por su coste y su velocidad.
TypeSafe AI ha soltado Jev, un modelo que no conversa. No escribe texto libre, no resume documentos y no mantiene una charla. Solo hace tres cosas: elegir entre un conjunto cerrado de opciones, ordenar elementos según un criterio que le des y responder sí o no a una afirmación. En una semana se ha convertido en el tema del que habla medio sector, y no por lo que hace, sino por lo que cuesta hacerlo.
Decisiones, no párrafos
El entrenamiento no usa RLHF, el ajuste por retroalimentación humana que popularizaron los modelos generativos, sino lo que la empresa llama aprendizaje por refuerzo para decisiones calibradas. La diferencia práctica es que no hay una respuesta correcta que premiar, sino una distribución de probabilidad que ajustar. Si le pasas una factura y le preguntas si debe pagarse, o a qué departamento va un correo, no devuelve una frase: devuelve, por ejemplo, un 80% para el equipo técnico y un porcentaje bastante menor para ventas. Los tres modos de consulta son elección múltiple, puntuación con rúbrica y Nool, la respuesta binaria.
Ese es todo el producto. Y ahí está el interés. Hay una cantidad enorme de procesos empresariales que necesitan una salida determinista y no pueden permitirse que un LLM se invente una historia plausible: enrutar correos, clasificar tickets, decidir si una factura se paga o a qué cola va un pedido. Un modelo de lenguaje sirve para eso, pero es caro y sobra casi todo lo que hace.
El segundo argumento es el coste. Las consultas se resuelven en paralelo, no token a token como un generador, y quien lo ha probado en estos días habla de una diferencia de hasta 50 veces frente a dejar la misma decisión en manos de un modelo grande. Esa cifra sale de casos de uso, no de un benchmark público. En velocidad juega el mismo factor: no hay decodificación secuencial que esperar.
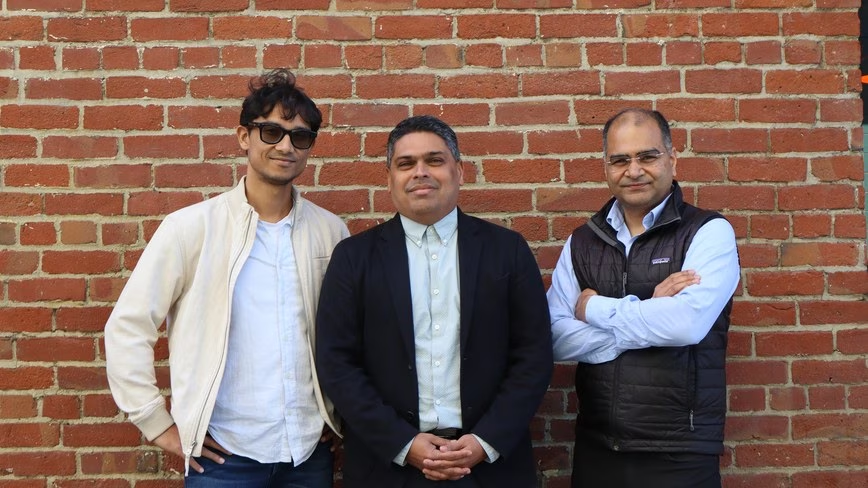
Detrás hay nombres con credibilidad, al menos uno vinculado antes a OpenAI, y eso explica buena parte del ruido. El campo lleva meses produciendo investigación interesante desde laboratorios chinos que no recibe ni la mitad de atención.
Y ahí conviene frenar. Que no se invente una historia no significa que acierte: si el modelo reparte probabilidades entre tres opciones, la equivocada sigue siendo una de ellas, solo que el error queda acotado y es medible. Lo que falta por ver es cómo se comporta cuando la decisión es difícil, con cuánta latencia en producción y bajo qué condiciones se despliega en un sistema que mueve dinero. De momento se ha contado la promesa y el entusiasmo, no los números.