Jev, el modelo de TypeSafe AI que clasifica rapido y no quiere ser un LLM
TypeSafe AI presenta Jev, un modelo que no genera texto: devuelve decisiones estructuradas con su probabilidad. La compania lo llama System One Model y lo separa de los LLM de proposito general.
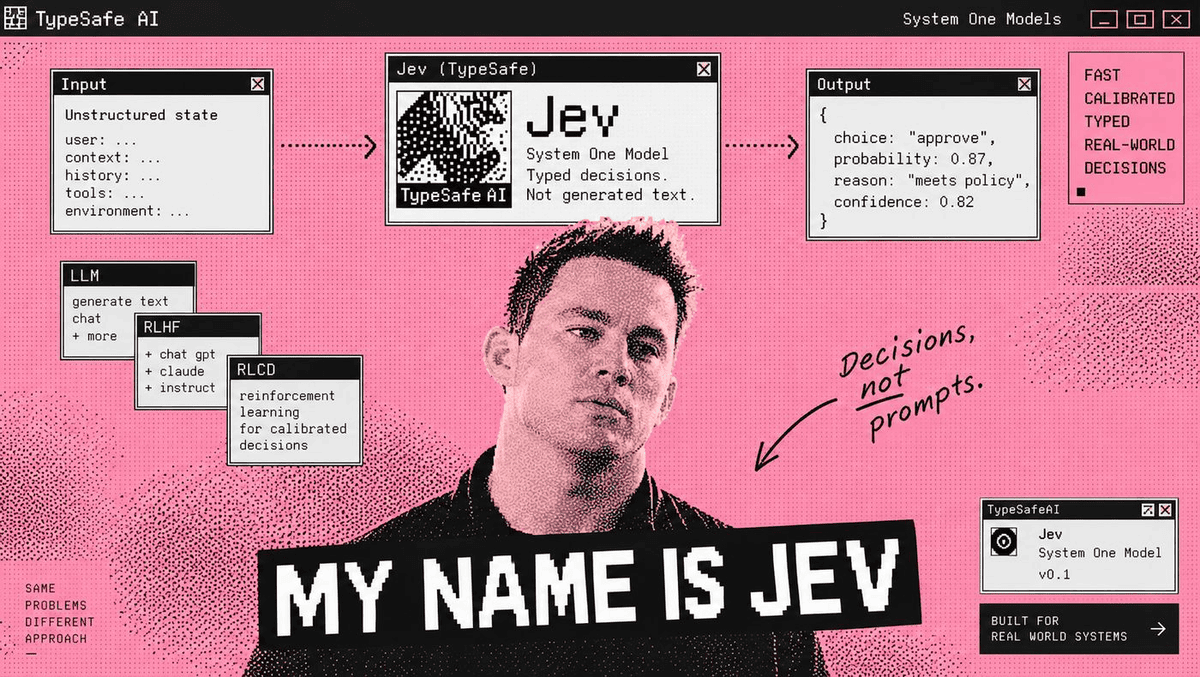
TypeSafe AI ha presentado Jev, un modelo que no escribe texto. Recibe una frase y devuelve una distribucion de probabilidad sobre un conjunto cerrado de etiquetas. La compania lo llama System One Model y lo coloca en las antipodas de los LLM de proposito general. Para un mensaje de soporte como "me suscribi ayer y ahora no puedo acceder a lo que pague", Jev no redacta una respuesta: reparte Technical 64%, Sales 23%, Billing 13%, Cancellation 0%.
Que devuelva tambien las probabilidades y no solo la etiqueta ganadora es la parte util en produccion. Una aplicacion puede enrutar el ticket automaticamente cuando la confianza es alta y mandar a revision manual los casos ambiguos. Clasificacion, puntuacion, enrutado y deteccion de intencion no son problemas nuevos de machine learning. Lo que TypeSafe dice hacer distinto es construir el modelo alrededor de ese trabajo desde el principio, en lugar de coger un LLM generalista y pedirle por prompt que se comporte como un clasificador.
El problema es viejo; la arquitectura quiza no
Jev se parece bastante a un clasificador zero-shot. Ya se puede dar un texto y un conjunto arbitrario de etiquetas candidatas sin entrenar un modelo especifico para esas categorias, y obtener una probabilidad por etiqueta. Los clasificadores zero-shot basados en NLI se popularizaron hacia 2019-2020, y modelos como facebook/bart-large-mnli llevan anos usandose para eso. Llamar a Jev un clasificador viejo con otro nombre tampoco seria justo: TypeSafe habla de decisiones estructuradas multiples, inferencia en paralelo y un entrenamiento centrado en la calibracion, que es justo lo que suele fallar cuando se improvisa un clasificador con un LLM.
Y no, no es un LLM al estilo de GPT, Claude o Gemini. Aquellos son de proposito general y estan hechos para programar, razonar, usar herramientas y generar texto abierto. Jev es mucho mas estrecho. Se puede forzar a un LLM moderno a hacer algo parecido con salidas estructuradas, function calling o decodificacion restringida, pero sigues pagando un modelo grande y caro para una tarea de clasificacion. De ahi que Jev pueda ser mas barato y rapido: no genera token a token, decide directamente.
Cuanto de esto se puede comprobar
Poco, de momento. TypeSafe reporta alrededor de un 68% en su propia evaluacion de flujo de trabajo, pero eso no equivale a decir que acierte el 68% de las decisiones reales: las respuestas de referencia salen de modelos frontera, no de una verdad verificada de forma independiente. Hay pruebas externas tempranas, como un test pequeno de verificacion de hechos con un 96,3% de acierto y otro sobre 275 documentos que encontro coincidencia alta en algunas tareas de clasificacion. Son muestras pequenas. Tampoco se conoce la arquitectura interna, el tamano del modelo ni como se entreno.
La parte que importa para quien despliega esto es economica y de arquitectura: si un clasificador barato, rapido y bien calibrado resuelve el enrutado, sobran las llamadas a un modelo frontera para esa tarea. La pregunta abierta es si la calibracion se mantiene fuera del banco de pruebas de su creador. Mientras no haya benchmarks independientes serios, el 68% es una cifra suya.


