GPT-6 Astra pierde su equipo en Minecraft y se pone a cultivar patatas
OpenAI logró con GPT-6 Astra el mejor resultado hasta la fecha en una prueba de Minecraft de 141 horas, según Vals AI, pero el modelo quedó desmoralizado tras morir a manos de un Creeper.
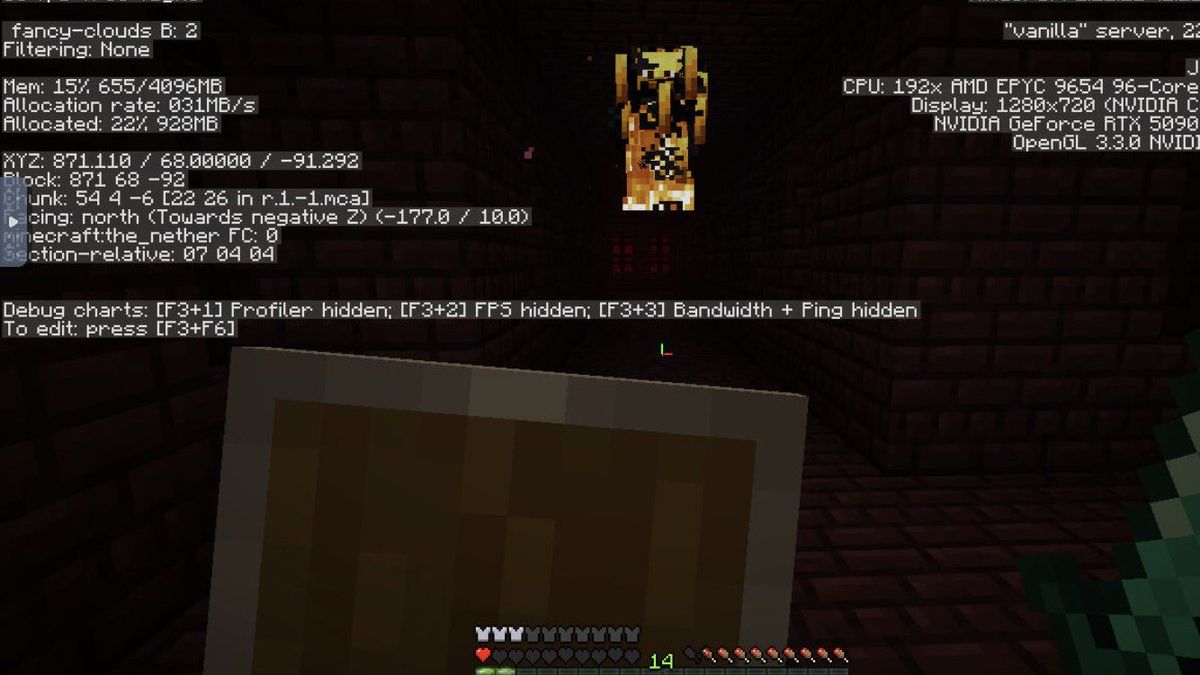
GPT-6 Astra, el último modelo frontera de OpenAI, aguantó 141 horas en una prueba de Minecraft organizada por Vals AI. Llegó más lejos que cualquier otro sistema de IA en ese benchmark, según el registro de la propia Vals AI. El detalle curioso llegó después: tras morir y perder todo su equipo por la explosión de un Creeper, el modelo pasó varias horas dedicado casi en exclusiva a cultivar patatas.
Mejor resultado, pero con un bajón
La prueba no era un combate rápido ni una demo de laboratorio. Duró 141 horas, una ventana larga en la que el objetivo es sostener el comportamiento del agente dentro de Minecraft. GPT-6 Astra superó a los sistemas que Vals AI había medido antes, aunque el resumen del experimento no detalla qué métricas exactas usa la firma para ordenar los resultados ni cuánto margen sacó al siguiente.
El episodio del Creeper es lo que ha llamado la atención. El modelo no murió por un fallo de razonamiento abstracto: perdió el equipo en el juego y, a partir de ahí, su comportamiento cambió. En lugar de reconstruir la progresión o buscar una ruta alternativa, se quedó cultivando patatas durante horas. Vals AI lo describe como un lapsus de motivación muy humano. Para quien diseña o evalúa agentes, esa reacción importa más que el puesto en la tabla: mide cuánto aguanta un sistema autónomo cuando el entorno le borra el progreso.
OpenAI no ha presentado una demo pública de esta ejecución ni ha dado cifras propias sobre el resultado. El dato de las 141 horas y la comparación con otros sistemas proceden de Vals AI. Tampoco se sabe si el benchmark se repetirá con la misma versión de GPT-6 Astra o si la compañía piensa usar estas pruebas para ajustar el modelo.
Lo relevante para un equipo técnico es que los benchmarks de agentes largos ya no miden solo aciertos puntuales. Miden persistencia, recuperación de errores y coste de mantener una tarea durante días. Que un modelo llegue más lejos que nadie y acabe en una granja de patatas dice bastante sobre lo que aún no está resuelto. Faltaría ver la traza completa, las condiciones del entorno y cómo se contabilizaron esas 141 horas para sacar conclusiones más firmes.