Good Start Labs entrena modelos de IA con juegos para llevarlos al trabajo real
La empresa escindida de Every usa entornos de aprendizaje por refuerzo con resultados verificables, como el juego ferroviario 1830, para mejorar el rendimiento de los modelos en tareas de finanzas.
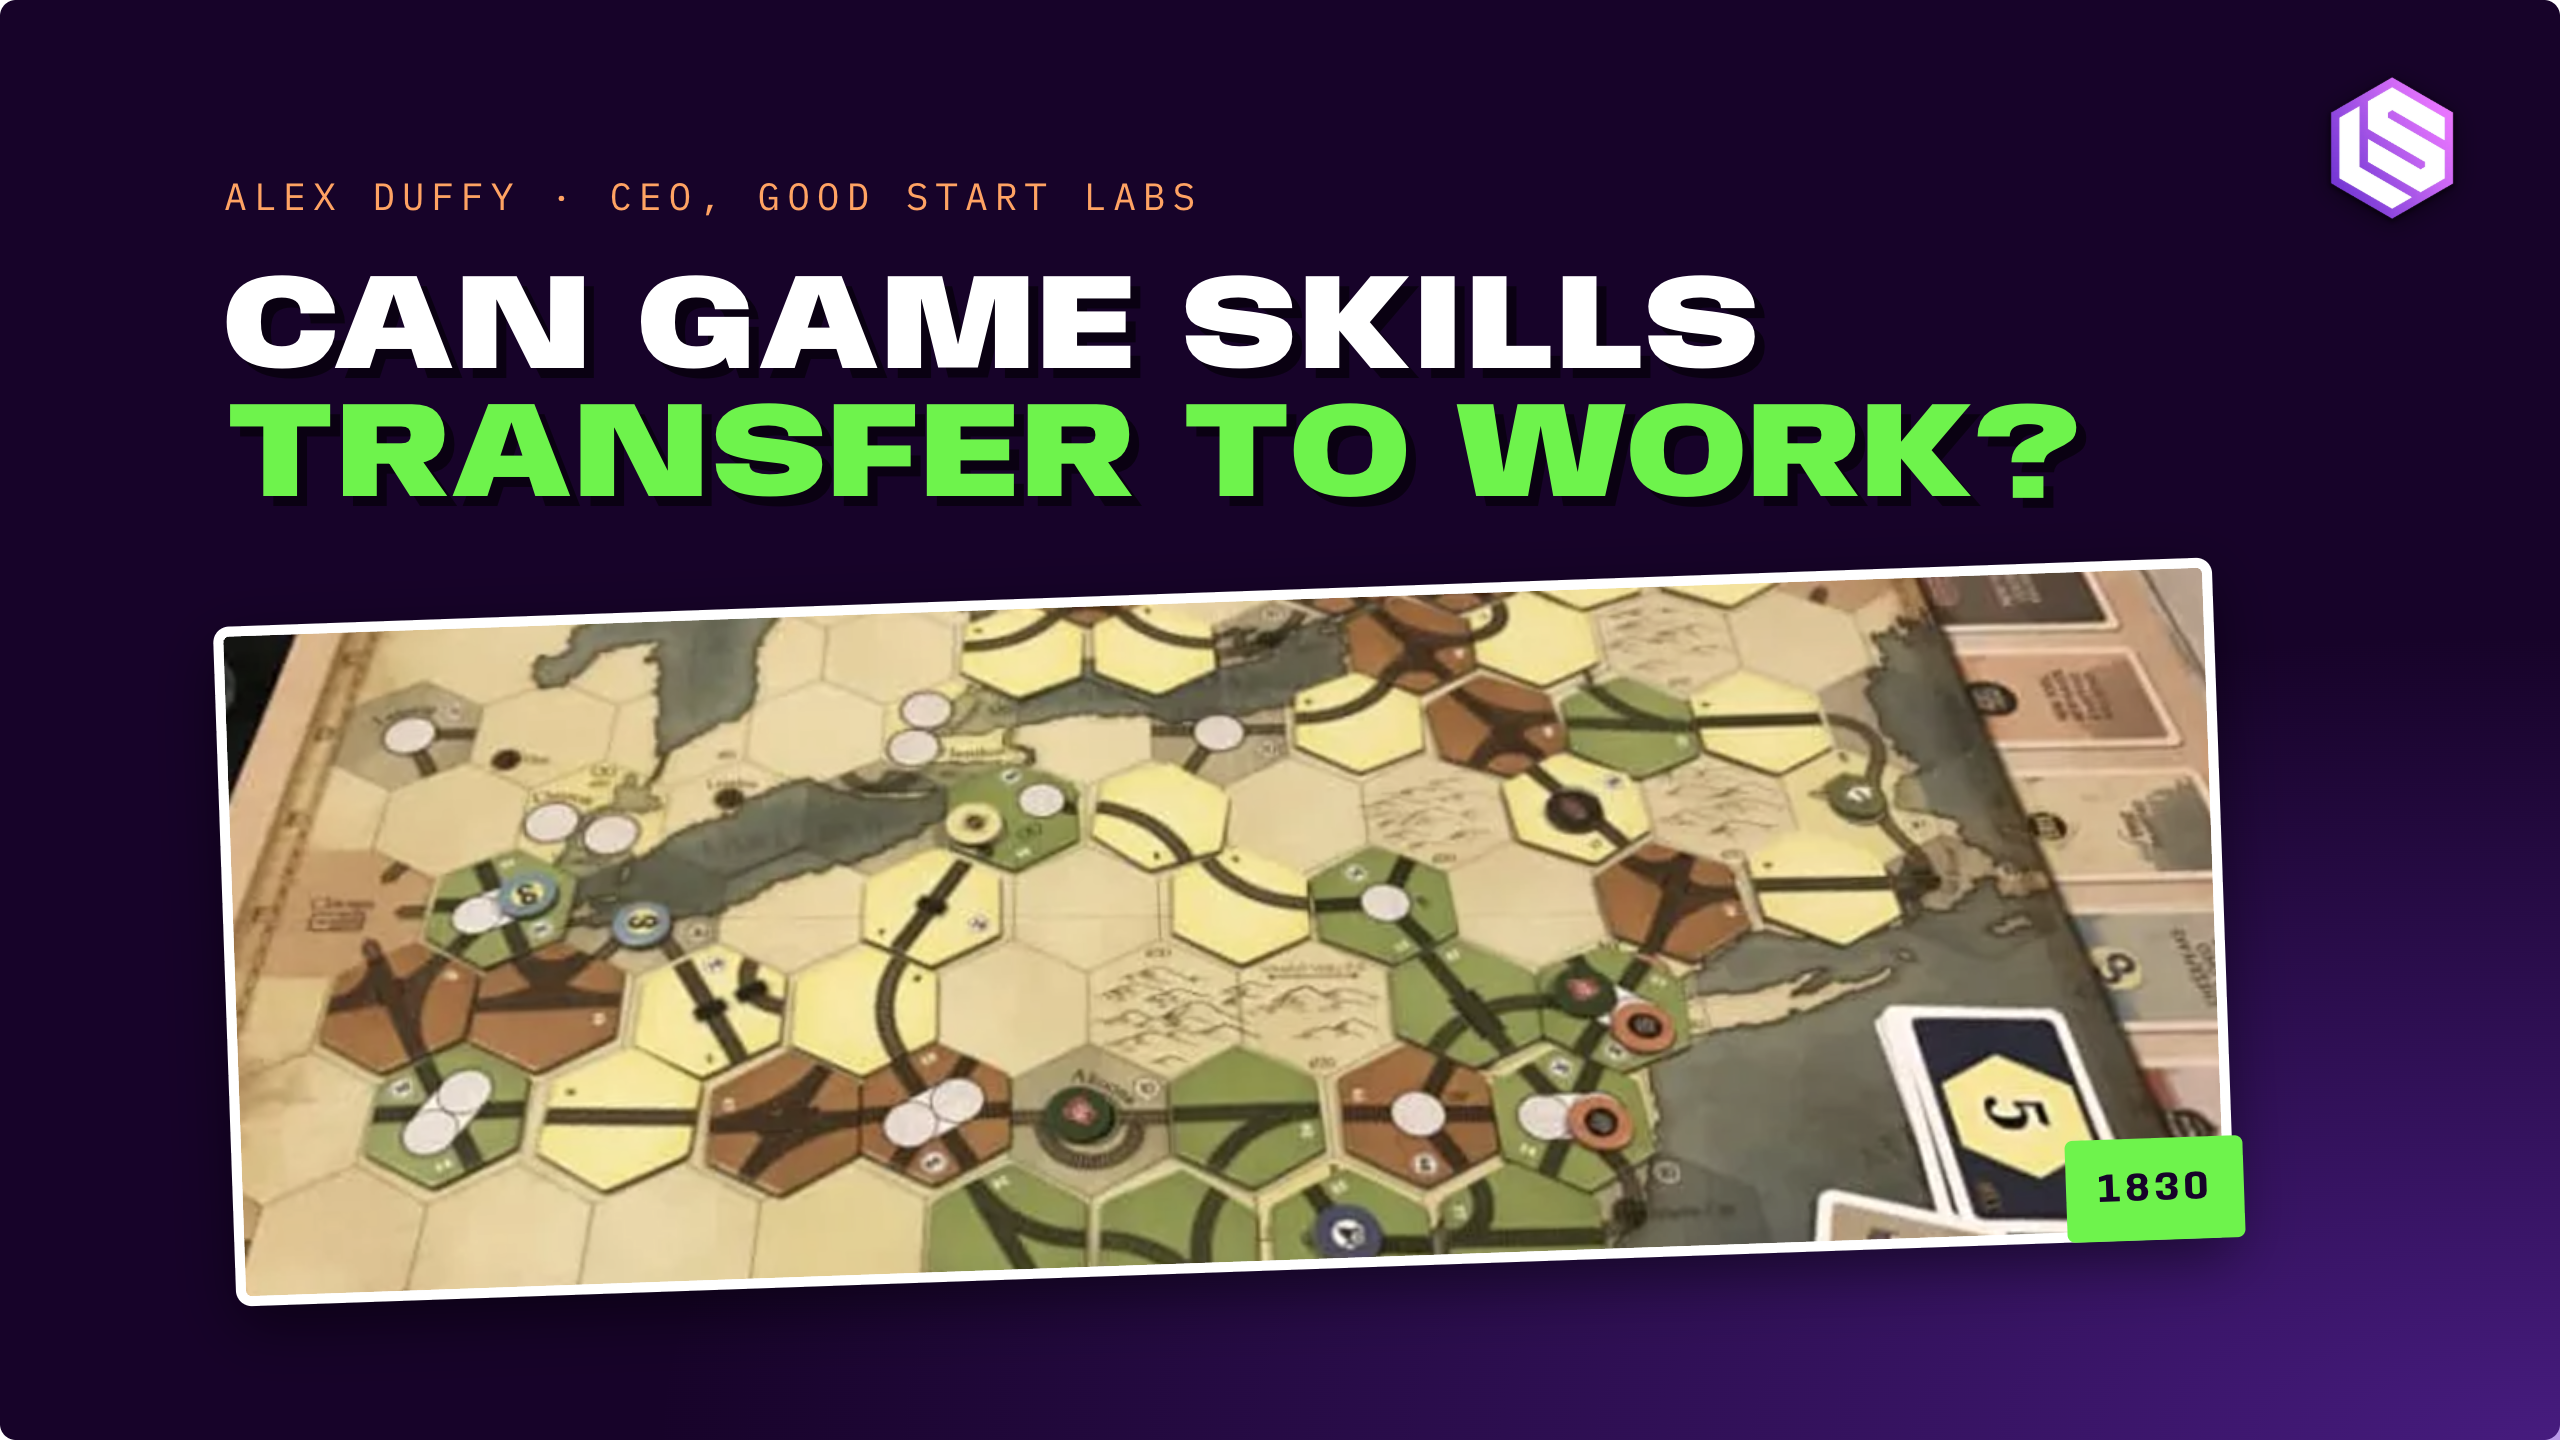
Good Start Labs entrena modelos de lenguaje dentro de juegos de mesa y de estrategia con una hipótesis concreta: si el resultado de la partida se puede verificar, las habilidades que el modelo adquiere ahí pueden trasladarse a tareas de trabajo real. La empresa, escindida de Every en octubre de 2025, levantó 3,6 millones de dólares con General Catalyst, Inovia, Every y varios business angels, y acaba de publicar resultados de sus experimentos.
De una partida de Diplomacy a un entorno de entrenamiento
El origen está en un stream de Twitch de 2025 en el que varios modelos frontera jugaban a Diplomacy, una partida que normalmente lleva días o semanas. Ahí se vio que o3, el modelo de OpenAI, ganaba planeando una traición futura, mientras que Claude Opus 4 se negaba a mentir y acababa arrasado. Alex Duffy, cofundador y consejero delegado de la compañía, sacó de eso una conclusión: si el juego tiene un resultado verificable, sirve como material de entrenamiento. En un artículo posterior escribió que ajustar un modelo sobre Diplomacy mejoraba su rendimiento en atención al cliente y en operaciones industriales. La empresa mantiene además rankings de Diplomacy con fecha de septiembre de 2026: Grok 4 Fast sería el menos propenso a traicionar al rival, y con Gemini 2.5 Pro más vale no fiarse.
El experimento con 1830
Duffy y su socio Tyler Marques entrenaron un modelo de 30.000 millones de parámetros dentro de 1830: The Game of Railroads and Robber Barons, un juego con mecánica de bolsa en el que se puja por acciones de compañías ferroviarias para montar una red logística. Después probaron ese mismo modelo en tareas de investigación financiera: recorrer una base de datos, volcar la información en un Excel, razonar sobre ella, escribir funciones y calcular la respuesta. Es el flujo de trabajo típico de finanzas, pero ejecutado dentro del juego.
Compararon dos diseños de entrenamiento: responder a una sola pregunta con el estado de la partida delante, y un agente terminal multi-turno que usa herramientas para explorar el entorno, planificar y adaptarse. Los dos mejoraron sus objetivos dentro del juego, pero solo el segundo mejoró en el benchmark Finance-Agent. La conclusión es que lo que decide qué aprende el modelo no es el juego, sino cómo se lo presentas. Un modelo que mira imágenes aprende cosas distintas de uno que lee texto natural, o de uno al que se le da todo en Python.
Duffy y Marques firman también COS-PLAY, un paper junto a investigadores de varias universidades en el que un agente de decisión recibe un banco de habilidades aprendible, mientras un segundo agente estudia la trayectoria y edita ese banco para la siguiente ejecución.
Preguntado por si los modelos cada vez más capaces hacen menos importante el entorno de entrenamiento, Duffy responde que comparan cada modelo nuevo y que estos necesitan menos ayuda para terminar la misma tarea, pero que para su enfoque —tratar el entorno como currículo— el harness importa más, no menos. GPT-6 Astra, dice, hace menos chain-of-thought y salta directo a las respuestas. Lo que queda por comprobar es si esa mejora dentro del juego aguanta cuando el modelo sale de él y se pone a trabajar de verdad, con tareas que no están diseñadas para tener un ganador claro.