Entrena un modelo de mundo de 12,5 millones de parámetros en una sola RTX 3080 Ti
Un desarrollador conocido como stmonty ha enseñado a una IA a jugar a Pokémon Red en una GPU de consumo, prediciendo el siguiente fotograma en vez de recibir reglas.
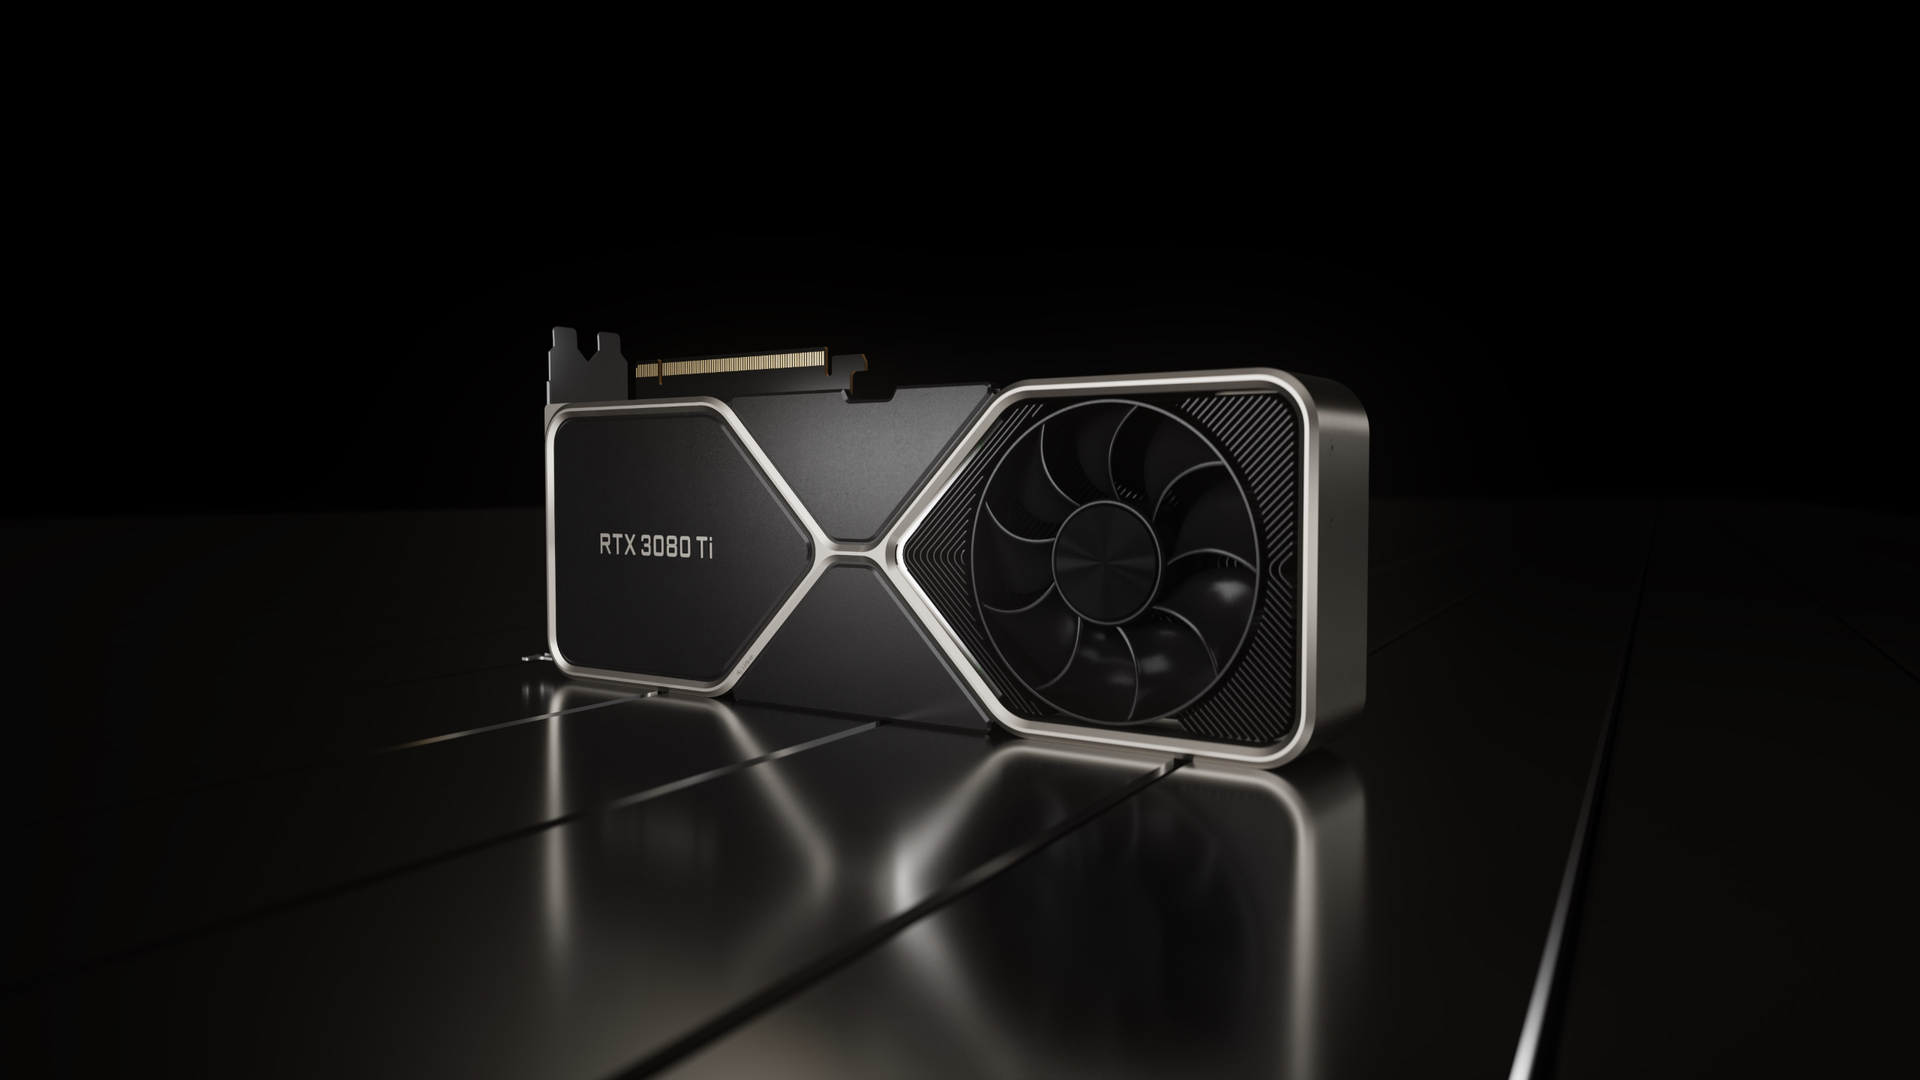
Un desarrollador que firma como stmonty ha entrenado un modelo de mundo en una sola RTX 3080 Ti, una tarjeta de gama de consumo, para que juegue a Pokémon Red. Lo interesante no es el juego, sino cómo aprende: no recibe reglas ni un árbol de decisiones, sino que predice qué va a pasar a continuación y de ahí deduce para qué sirve cada botón.
Lo cuenta en su blog, en una entrada titulada «Enseñar a un modelo de mundo a jugar a Pokémon», publicada el 20 de septiembre. El modelo arranca desde una partida guardada y tiene que resolver la elección del Pokémon inicial.
Qué aprende exactamente
Un modelo de mundo no mapea estado a acción como un agente clásico de refuerzo. Aprende a simular el entorno: dado el estado actual y una acción, genera el estado siguiente. Aplicado a Pokémon Red, eso significa producir el siguiente fotograma de la partida. El control emerge como efecto secundario, porque para acertar el fotograma hay que entender qué hace cada pulsación.
El proyecto se apoya en LeWorldModel, una línea de investigación firmada, entre otros, por Yann LeCun. LeCun dejó Meta el año pasado para montar AMI Labs y construir modelos de mundo con este mismo enfoque. La diferencia aquí es la escala: lo que en un laboratorio se reparte entre clústeres de GPUs, en este caso cabe en una tarjeta que cualquiera tiene montada en su torre.
El modelo tiene unos 12,5 millones de parámetros. Para hacerse una idea, un LLM que la gente ejecuta en local suele rondar los 7.000 millones: esto es tres órdenes de magnitud menos. stmonty explicó en un foro de discusión que eligió este camino precisamente porque podía entrenarlo en local, sobre hardware de consumo, y que el objetivo era «aprender y divertirse un rato».
Quien quiera mirar el detalle tiene el post del desarrollador, donde se repasa el proceso de entrenamiento.
Por qué merece la pena mirarlo
Los modelos de mundo llevan meses sonando como alternativa a los LLM para tareas con entorno físico o interactivo, y hasta ahora casi todo lo publicable venía de laboratorios con presupuesto. Un experimento de este tamaño demuestra que la técnica se puede tocar sin alquilar nada: si tienes una GPU decente en casa, el cuello de botella es el tiempo y el diseño del dataset, no el dinero.
Falta lo de siempre en este tipo de proyectos: no hay repositorio ni licencia publicados, así que reproducirlo pasa por reconstruir el pipeline a partir de lo que se cuenta. Tampoco hay métricas de cuánto aguanta el modelo jugando, ni comparación con un agente entrenado por refuerzo. Es un cuaderno de bitácora, no un paper.