DeepSeek lanza DeepSeek‑V4.1‑Flash, modelo Mixture‑of‑Experts de 552 B con 1 M de contexto
El nuevo modelo reduce el prefill a 8 B y el KV cache a 890 bytes por token, lo que lo hace más barato y eficiente para agentes de larga duración
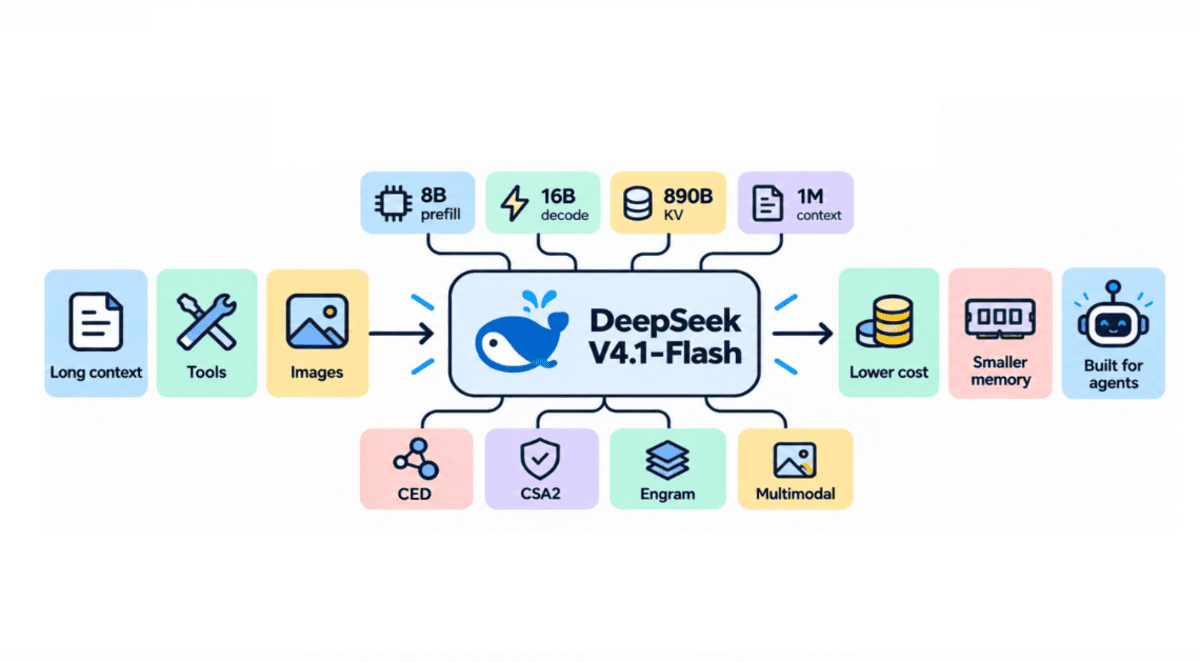
DeepSeek ha sacado a la luz DeepSeek‑V4.1‑Flash, un Mixture‑of‑Experts de 552 B que mantiene solo 8 B activos durante el prefill y 16 B durante la decodificación. El modelo admite ventanas de contexto de 1 M tokens y combina texto e imágenes, pero lo más relevante son los cambios de arquitectura que reducen el coste de cómputo y la huella de memoria.
La propuesta central es el Causal Encoder‑Decoder (CED), que separa la fase de lectura (prefill) de la de generación (decode). En lugar de generar un KV global en cada capa del decoder, este obtiene la información del encoder final, lo que permite que el prefill sea mucho más ligero. El perfil de cómputo pasa de 552 B a 8 B por token en prefill y a 16 B en decode, una ventaja clara para agentes que leen cientos de miles de tokens antes de generar unos pocos.
Para el KV cache, DeepSeek introduce Compressed Sparse Attention 2 (CSA2). Los tres modos (Full, Reindex, Reuse) permiten que las capas compartan y reutilicen la información de memoria y de búsqueda, evitando duplicaciones. Además, se aplica un Hierarchical Sparse Indexer que reduce la cantidad de tokens examinados en cada capa, y FP4 KV caching que almacena la caché en formato de 4 bits, reduciendo la huella a 890 bytes por token. En un contexto de 1 M, la caché global ocupa apenas 890 MB.
El modelo se entrenó desde cero con 45 T de tokens multimodales y añade un componente de memoria condicional Engram de 196 B, accedido de forma esparsa. La licencia MIT facilita su adopción en entornos corporativos.
Para quienes gestionan infraestructuras de IA, estos cambios significan menos memoria HBM y menor coste de ejecución, especialmente en pipelines de agentes que consumen grandes volúmenes de entrada. El repositorio oficial en Hugging Face permite descargar el modelo y los pesos de forma directa.
El lanzamiento demuestra que optimizar la arquitectura puede superar el simple aumento de parámetros. La comunidad observará cómo se adoptan estas técnicas en otros proyectos y si el modelo mantiene su rendimiento en escenarios de producción.