Cloudflare recorta un 90% las entradas de su tabla de hashes y libera 100 TB de RAM
La compañía baja de 100.000 a 10.000 las entradas del mapeo entre URL y servidor de caché en Pingora, su framework open source. El ahorro son 100 TB de memoria.
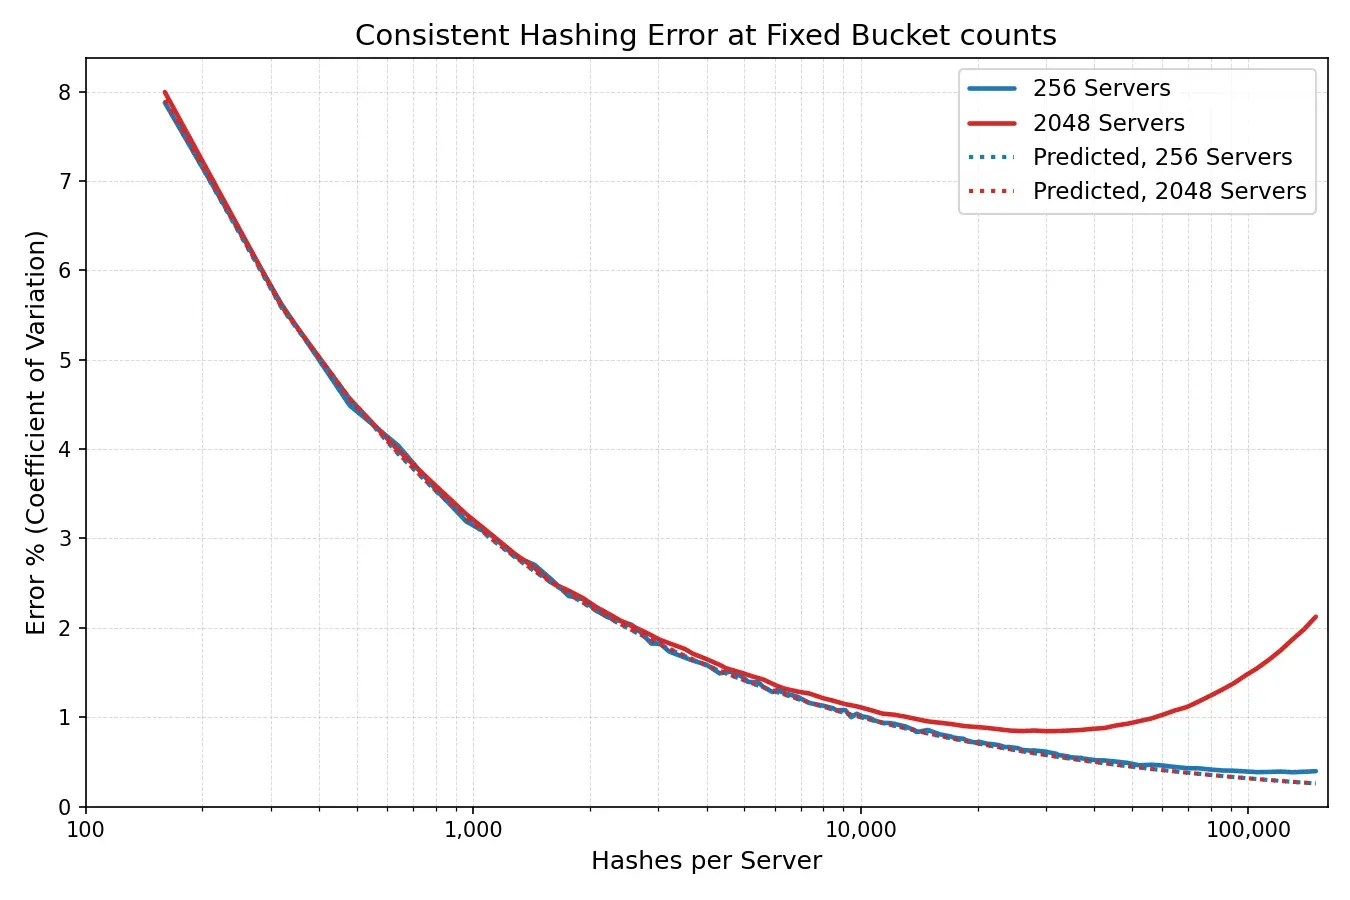
Cloudflare ha vuelto a liberar 100 TB de RAM en su infraestructura de caché, y esta vez el ahorro no sale de tocar el hardware ni el servidor que sirve las peticiones, sino la tabla que decide en qué servidor vive cada URL. La compañía ha recortado un 90% el número de entradas de ese mapeo: de 100.000 a 10.000.
El caso de uso es el de siempre: servir una URL desde memoria o disco en lugar de ir a buscarla al sitio de origen, que es lo que da sentido a una red de caché y ahorra el viaje completo hasta el backend real. Cloudflare reparte ese trabajo con Pingora, el framework open source que la empresa usa para esta tarea. Y dentro de Pingora, quien decide qué servidor atiende cada URL es Ketama, una implementación de hashing consistente.
Una tabla que crece con la flota
El mecanismo se cuenta en dos frases y se opera con dificultad. Se calcula el hash de la URL entrante, se calcula el hash de cada servidor (por IP y por nombre, por ejemplo) y se emparejan por proximidad numérica. Ese emparejamiento vive en tablas en memoria, y ahí está el problema: en una flota donde los backends aparecen y desaparecen de forma constante, y a la escala que maneja Cloudflare, esas estructuras se hinchan. Cada entrada es RAM pagada.
Recortar de 100.000 entradas a 10.000 es reducir la estructura en un orden de magnitud, y de ahí salen los 100 TB. No es la primera vez que la compañía anuncia un ahorro de ese tamaño: ya lo hizo antes por otra vía, según recuerda el propio anuncio.
Queda por ver el detalle fino del cambio. Qué se sacrifica en precisión del reparto, cómo se comporta la tabla cuando caen nodos y cuánto tarda en recolocarse son preguntas sin respuesta pública por ahora. Las cifras son de Cloudflare, no de una medición independiente.
Para quien mantiene una flota de caché con hashing consistente, la parte reutilizable es la idea de fondo: en un despliegue grande, la estructura que enruta puede pesar tanto como los datos que sirve, y se puede adelgazar sin tocar una sola máquina. Si el reparto mantiene los mismos aciertos de caché con una décima parte de la tabla, ahí hay una línea de trabajo para el resto.