Anthropic y OpenAI lanzan sus modelos frontera con 90 minutos de diferencia
Claude Opus 5.5 se pone líder del índice de inteligencia de AA con 58 puntos y un 40% menos de precio, mientras GPT-6 Sol y Luna recortan su tarifa a la mitad.
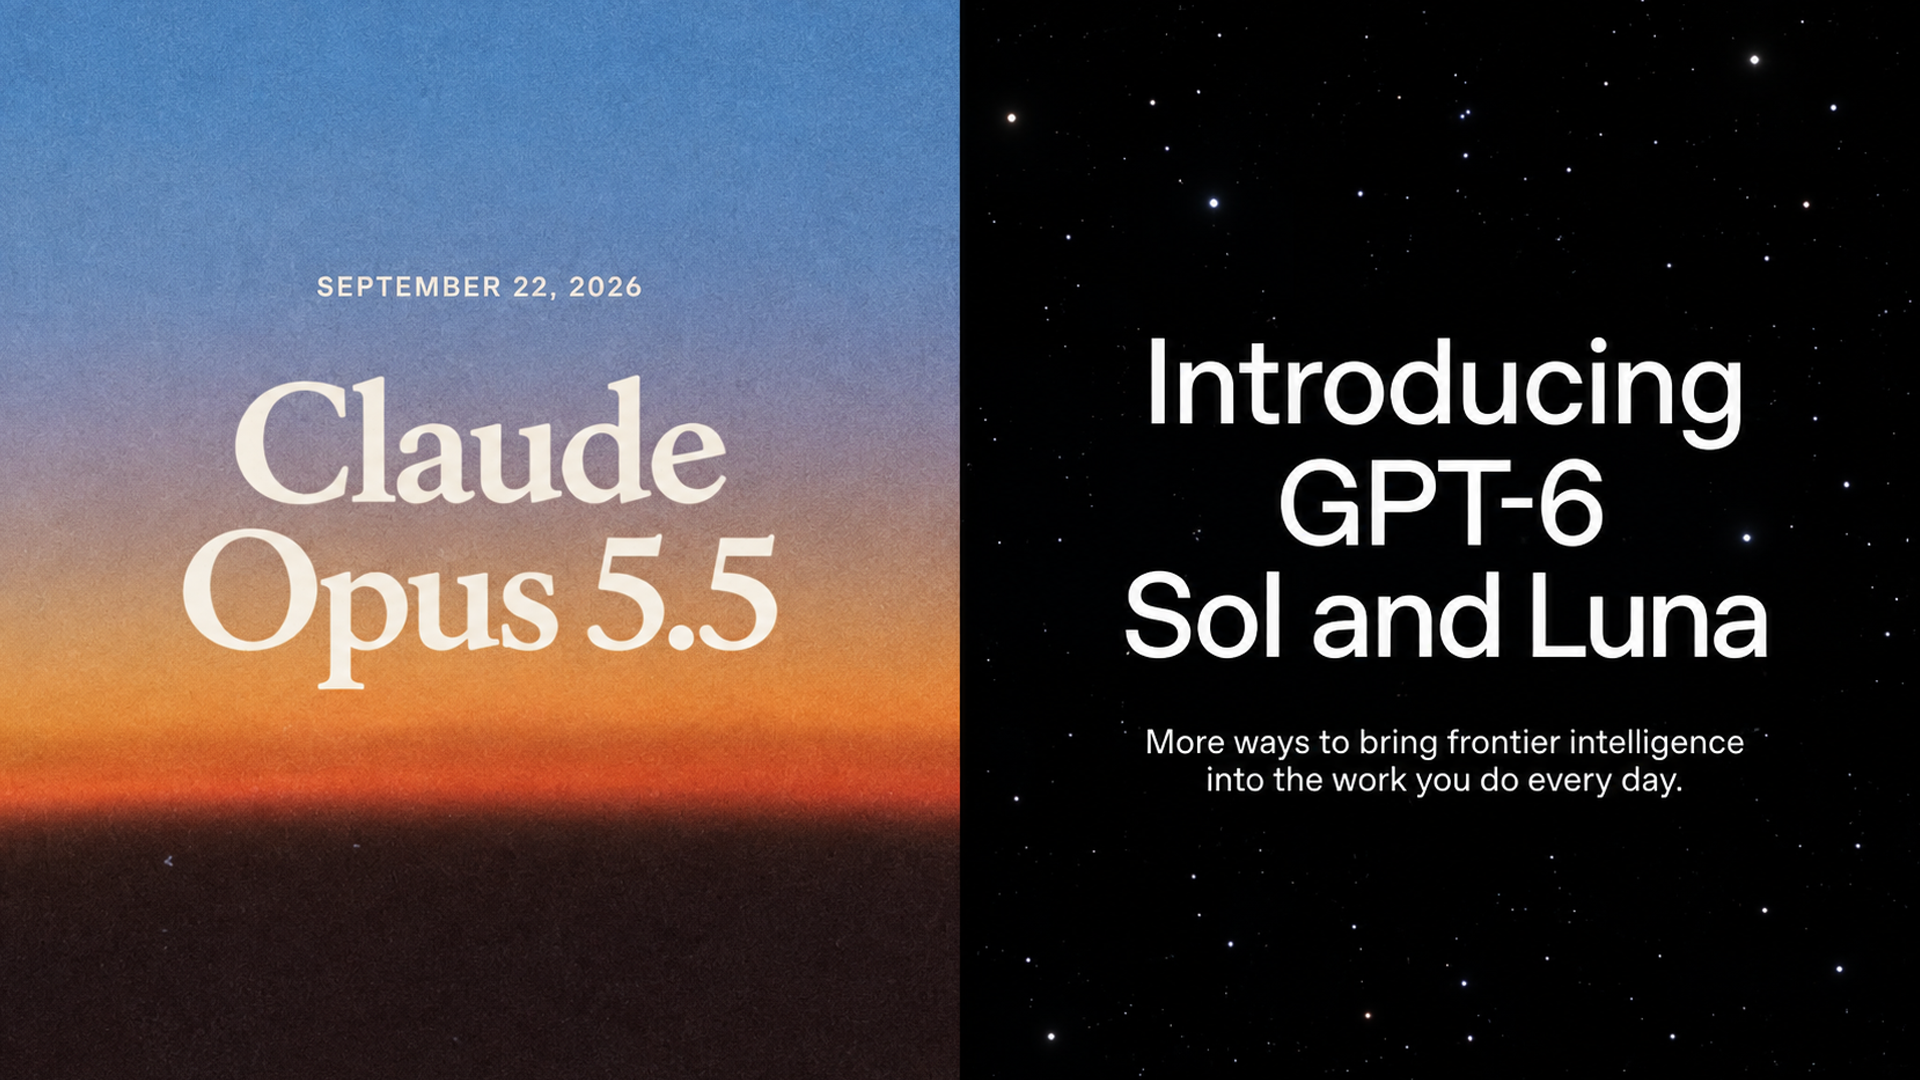
Anthropic y OpenAI han publicado modelos frontera con 90 minutos de diferencia, y las dos han movido ficha en lo que más mira quien acaba pagando la factura: el precio. Claude Opus 5.5 sale un 40% más barato que su predecesor y se coloca primero en el índice de inteligencia de AA, mientras que GPT-6 Sol y Luna llegan con la mitad de tarifa que los modelos a los que sustituyen.
Lo que miden los números
Opus 5.5 alcanza 58 puntos en el índice de AA. Los que mandaban hasta ahora, Fable 5.1 y GPT-6 Astra, se quedaban en 53. Anthropic dice que ha trabajado el estilo de escritura, ese tono "Claudish" que le venían criticando, y asegura que el modelo se ciñe más a las reglas que le da el usuario y suelta menos jerga. También afirma que 5.5 ha firmado la mejor puntuación hasta la fecha en sus pruebas internas de alineación, y lo presenta como el primer lanzamiento después de sus llamamientos al "pacing". Sam Altman ha venido a decir lo mismo desde el otro lado: marcar el ritmo no es parar.
La respuesta de OpenAI es más de precio que de capacidad. GPT-6 Sol y Luna suben ligeramente respecto a sus equivalentes 5.6, pero cuestan la mitad. Luna se queda en 0,10 y 0,50 dólares por millón de tokens; Sol, en 2 y 10. Los datos de rendimiento y de tarifa salen de las dos compañías, no de un tercero, salvo el índice de AA.
Matemáticas con revisores
OpenAI dice que uno de sus modelos internos ha resuelto más de 100 problemas abiertos de matemáticas desde que empezó a entrenar el 28 de agosto, y ha montado un grupo asesor con nueve matemáticos para decidir cómo salen esos resultados al exterior. La cifra es suya, no de un tercero. El grupo tiene sede en el Institute for Advanced Study de Princeton y en él están Timothy Gowers, Martin Hairer y Melanie Matchett Wood. Sus miembros no cobran de OpenAI y no opinan sobre la velocidad a la que la compañía empuja la investigación matemática, solo sobre la verificación y la publicación de lo que ya ha salido.
El contexto: a principios de mes, 27 medallistas Fields, Hairer entre ellos, firmaron una carta en la que acusaban a los laboratorios de IA de publicar resultados a toda prisa, sin crédito ni comprensión reales.
Ese es el cuello de botella que el grupo asesor no resuelve. Más de cien resultados en menos de cuatro semanas, cada uno pendiente de una revisión humana de corrección, originalidad y autoría. El grupo puede decidir cómo se revisan y cómo se publican, pero no cuántos se producen. Y mientras eso se ordena, las dos compañías siguen bajando precios.