Agoda cambia su caché de precios de 72 shards de SQL Server a DragonflyDB
La empresa mueve 1,5 TB de precios en memoria con 300.000 lecturas y 1,5 millones de escrituras por segundo, y mide una mejora de ocho veces en la latencia P99.
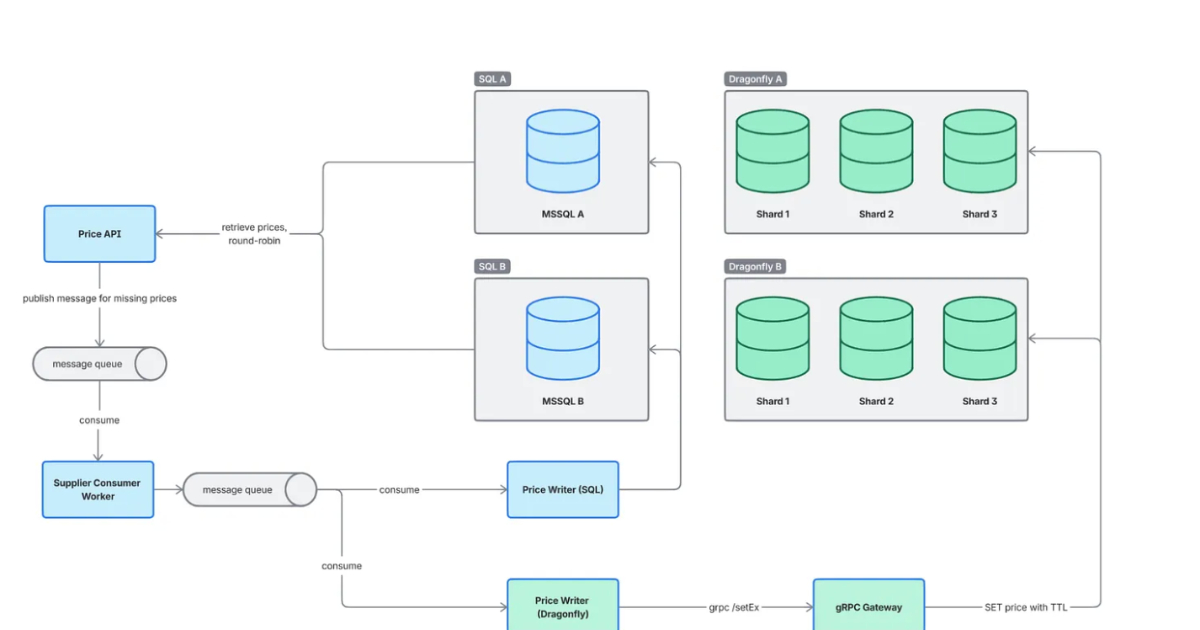
Agoda ha reemplazado el despliegue de SQL Server de 72 shards que sostenía su caché de precios de hoteles por DragonflyDB, un almacén de datos en memoria. La caché guarda alrededor de 1,5 TB de precios volátiles y mueve del orden de 300.000 lecturas y 1,5 millones de escrituras por segundo. Tras la migración, la compañía mide una mejora de unas ocho veces en la latencia P99 de lectura.
El problema no era solo el volumen. La arquitectura anterior obligaba a enrutar los shards desde la propia aplicación, y escalar implicaba comprar bloques de hardware prefijados, reasignar shards a mano y migrar datos. A principios de 2024 el equipo duplicó la capacidad y en menos de un año estaba otra vez cerca del techo. Además hacía falta un proceso aparte para limpiar los datos caducados de proveedores. «Quedó claro que seguir añadiendo recursos a SQL Server no era una estrategia viable ni rentable a largo plazo», resume Clarkson Chang, ingeniero principal de Agoda.
Pruebas antes de mover un solo byte
El equipo evaluó DragonflyDB contra su carga real en lugar de fiarse de las pruebas publicadas. Encajaban la arquitectura multihilo sin estado compartido, la compatibilidad con Redis, el escalado por clústeres y la expiración de claves integrada, porque la caché se apoya sobre todo en MGET y SET. Para reproducir el tráfico usaron memtier_benchmark con una proporción de una lectura por cada seis escrituras y MGET de diez claves de media.
La migración fue por etapas. Primero desplegaron una instancia de 1 TB para los datos calientes, y el crecimiento orgánico la llevó al umbral del 90% de memoria. Después pasaron a un diseño de tres shards por clúster y ampliaron DragonflyDB hasta cubrir los 1,5 TB completos. El clúster resultante procesaba unos 1,6 millones de escrituras por segundo con una P99 de alrededor de 10 milisegundos.
Antes de tocar el tráfico de clientes activaron lecturas duales: SQL Server seguía respondiendo mientras la API de precios consultaba en paralelo DragonflyDB. No comparaban la respuesta completa, sino el número de proveedores y la longitud de los datos de precio, y lo publicaban como métricas de Prometheus. Ambos indicadores superaron el 99,9% de paridad. Luego un experimento A/B fue moviendo clientes de forma gradual hasta que, varias semanas después, el 100% del tráfico estaba migrado y las rutas de lectura y escritura de SQL Server se retiraron.
Conmutación sin coordinador central
Quedaba la alta disponibilidad. Agoda mantiene dos clústeres, A y B, y en vez de un coordinador central cada pod de la aplicación compara por su cuenta las tasas de acierto de caché con cinco minutos de observaciones locales. Una divergencia estadísticamente significativa de 10 puntos porcentuales marca un clúster como ilegible; para volver a la normalidad la diferencia debe caer dentro de tres puntos. En una simulación de caída, unos 40 pods detectaron el fallo y entraron en conmutación automática en unos dos minutos sin intervención manual.
El resultado no es solo menos latencia. Agoda se queda con un modelo de escalado menos rígido y con menos mantenimiento operativo alrededor de los datos caducados y de la conmutación.